Das Dashboard „Server Health“
Die Server unter den Services: Last gegenüber Kernen, Reserven bei Speicher und Deskriptoren, Socket-Zustände, I/O-Wait, Page Faults, Festplatte, CPU-Drosselung und Auslastung pro CPU. Jeder Service nennt seinen Host, daher wählt Service einen Server.
Für wen: Alle, die die Server am Laufen halten: Kapazität, Reserven und Druck.
Öffnen Sie es im Observatory unter Dashboards: Wählen Sie Server Health. Es ist ein integriertes Dashboard und daher schreibgeschützt; Save a copy erstellt eine Kopie, die Sie ändern können. Wie jedes Panel den Zeitraum liest, seine Farben und seine leeren Zustände, steht unter Ein Dashboard lesen.
Die Werkzeugleiste: die Filter Service, jeweils All, bis Sie einen Wert wählen, und der Zeitraum. Jedes Menü listet die Werte, die system.cpu.time im Zeitraum trägt. Jedes Panel unten nennt die Filter, die es eingrenzen.
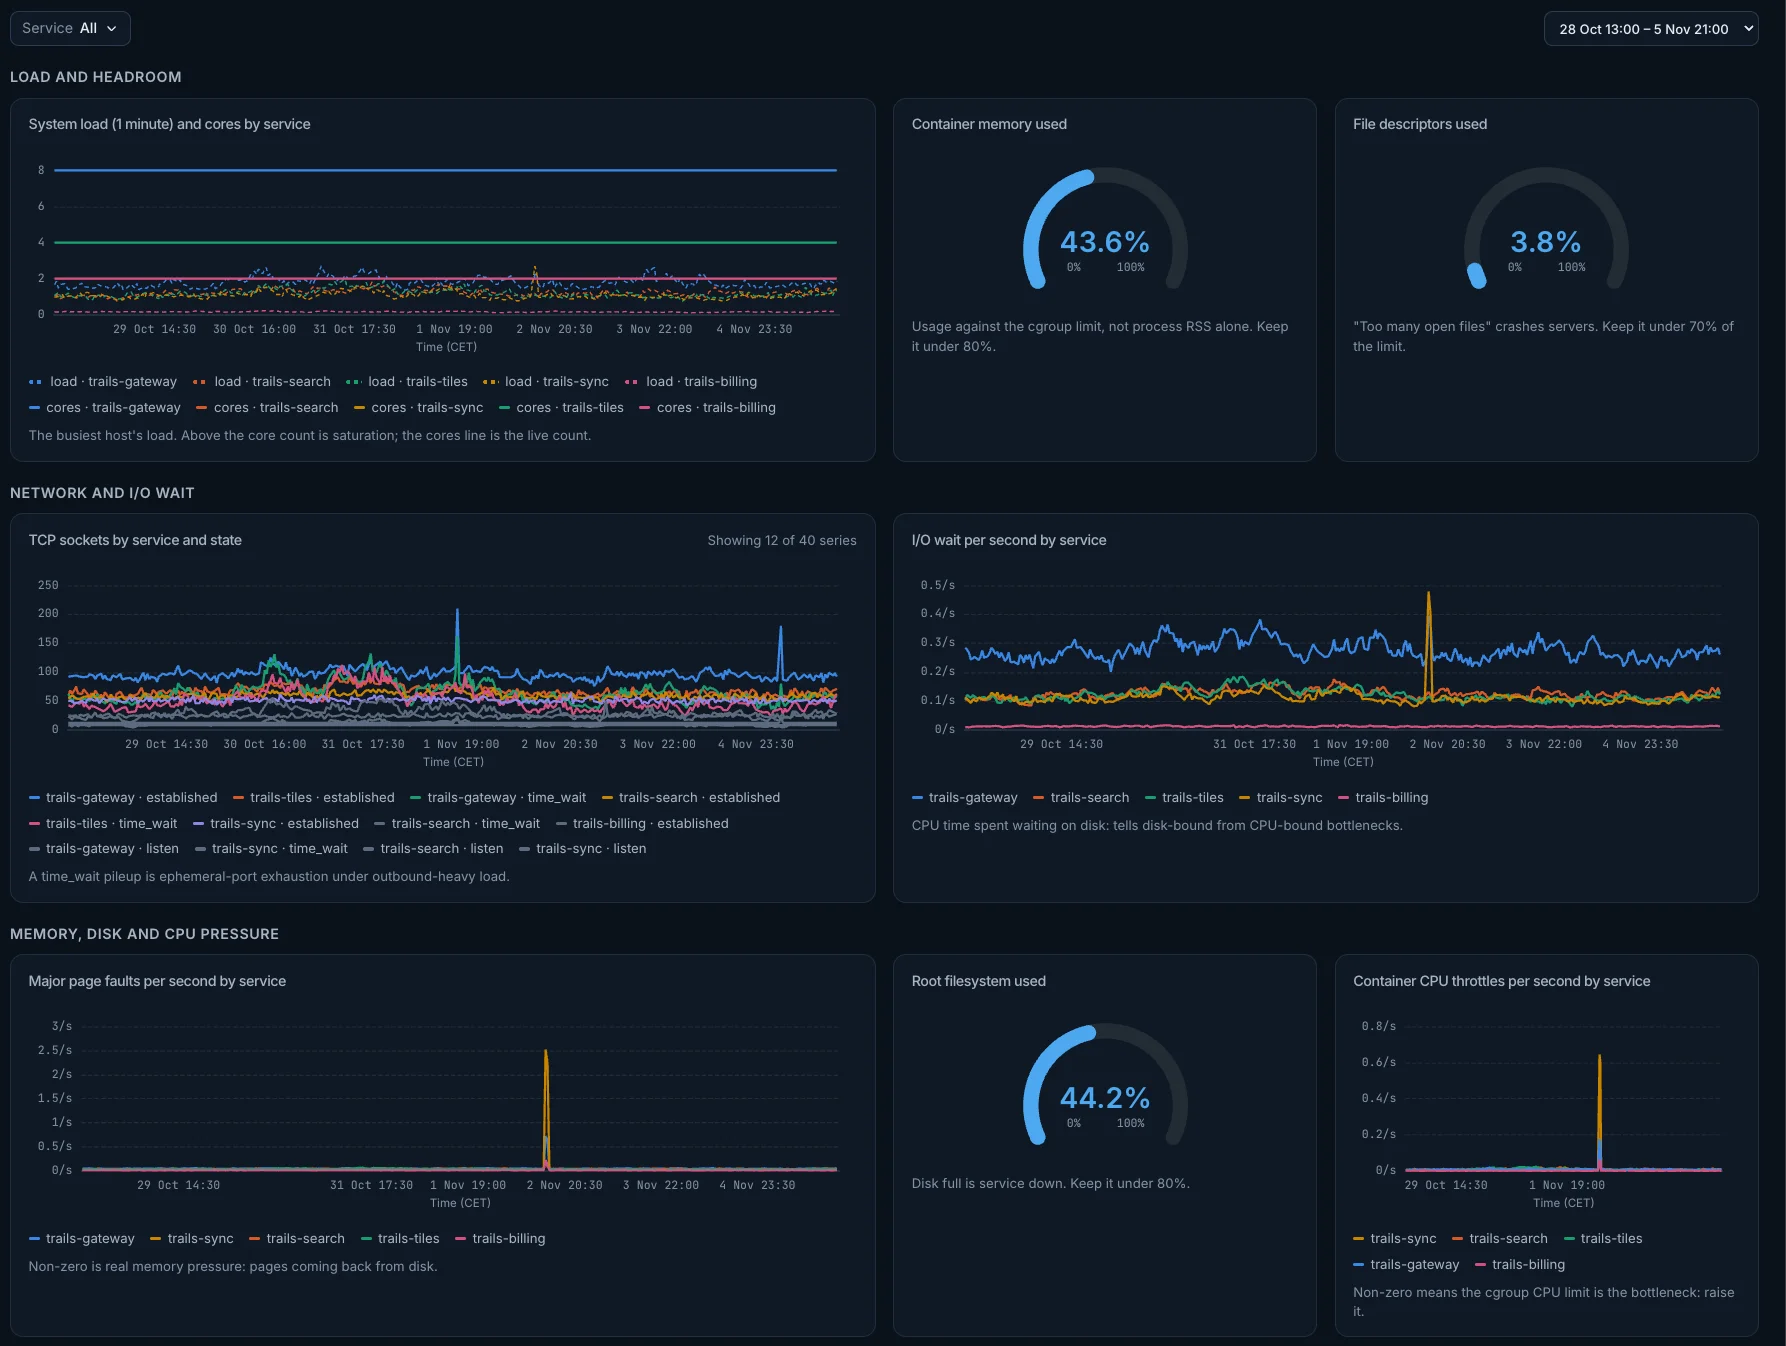
Load and headroom
System load (1 minute) and cores by service
Die Last des am stärksten ausgelasteten Hosts. Über der Anzahl der Kerne ist Sättigung; die Linie der Kerne zeigt die aktuelle Anzahl.
- Wie es berechnet wird: Zwei Linien pro Service: das höchste
dartastic.system.cpu.load_average.1mseiner Hosts und die Anzahl unterschiedlichercpu.logical_number-Werte aufsystem.cpu.time(die Kerne; die summierte Reihe trägt keine). Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
dartastic.system.cpu.load_average.1m.
Container memory used
Die Nutzung gegenüber dem cgroup-Limit, nicht nur der RSS des Prozesses. Halten Sie sie unter 80 %.
- Wie es berechnet wird: Das höchste
container.memory.usagegeteilt durch das höchstedartastic.container.memory.limit, in Prozent angezeigt. Eine Rundanzeige von 0 bis 100 %, eine Kennzahl für den gesamten gewählten Zeitraum. - Farben: Die Rundanzeige wird über 80 % gelb und über 95 % rot.
- Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
container.memory.usage.
File descriptors used
„Too many open files“ bringt Server zum Absturz. Halten Sie die Nutzung unter 70 % des Limits.
- Wie es berechnet wird: Das höchste
process.unix.file_descriptor.countgeteilt durch das höchstedartastic.process.open_file_descriptors.limit, nur aus Serverprozessen (denen ohneflutter.build.mode; der Prozess einer Flutter-App zählt hier nie), in Prozent angezeigt. Eine Rundanzeige von 0 bis 100 %, eine Kennzahl für den gesamten gewählten Zeitraum. - Farben: Die Rundanzeige wird über 70 % gelb und über 90 % rot.
- Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
process.unix.file_descriptor.count.
Network and I/O wait
TCP sockets by service and state
Ein Stau in time_wait bedeutet erschöpfte ephemere Ports bei viel ausgehender Last.
- Wie es berechnet wird:
system.network.connection.count, summiert, eine Linie pro Service undnetwork.connection.state, die zwölf häufigsten. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
system.network.connection.count.
I/O wait per second by service
CPU-Zeit, die mit Warten auf die Festplatte verbracht wird: unterscheidet Engpässe bei der Festplatte von Engpässen bei der CPU.
- Wie es berechnet wird: Die Rate pro Sekunde von
system.cpu.timemitcpu.modeiowait, nur aus den Reihen pro CPU (denen mit einercpu.logical_number), damit keine CPU-Zeit doppelt zählt, eine Linie pro Service. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
system.cpu.time.
Memory, disk and CPU pressure
Major page faults per second by service
Ein Wert über null ist echter Speicherdruck: Pages, die von der Festplatte zurückgeholt werden.
- Wie es berechnet wird: Die Rate pro Sekunde von
process.paging.faultsmitsystem.paging.fault.typemajor, nur aus Serverprozessen (denen ohneflutter.build.mode; der Prozess einer Flutter-App zählt hier nie), eine Linie pro Service. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
process.paging.faults.
Root filesystem used
Volle Festplatte heißt ausgefallener Service. Halten Sie die Nutzung unter 80 %.
- Wie es berechnet wird:
system.filesystem.usageauf dem Mountpoint/im Zustand used, summiert, geteilt durch das gesamtesystem.filesystem.usagedieses Mounts, summiert, in Prozent angezeigt. Eine Rundanzeige von 0 bis 100 %, eine Kennzahl für den gesamten gewählten Zeitraum. - Farben: Die Rundanzeige wird über 80 % gelb und über 90 % rot.
- Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
system.filesystem.usage.
Container CPU throttles per second by service
Ein Wert über null bedeutet, dass das CPU-Limit der cgroup der Engpass ist: Erhöhen Sie es.
- Wie es berechnet wird: Die Rate pro Sekunde von
dartastic.container.cpu.throttled.count, eine Linie pro Service. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
dartastic.container.cpu.throttled.count.
Processes and per-CPU
Process CPU time per second by service and mode
Die CPU-Zeit, die der Prozess jedes Service nutzt, nach Modus.
- Wie es berechnet wird: Die Rate pro Sekunde von
process.cpu.timenur aus Serverprozessen (denen ohneflutter.build.mode; der Prozess einer Flutter-App zählt hier nie), eine Linie pro Service undcpu.mode. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
process.cpu.time.
Process uptime by service
Die Zeit seit dem Start jedes Prozesses: Ein niedriger Wert ist ein kürzlicher Neustart.
- Wie es berechnet wird: Uptime: die letzte Meldung von
process.uptimepro Service, nur aus Serverprozessen (denen ohneflutter.build.mode; der Prozess einer Flutter-App zählt hier nie), die zwanzig höchsten. Eine Tabelle, jede Kennzahl für den gesamten gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
process.uptime.
Busy share of each CPU by service
Jede Linie ist eine CPU eines Hosts: der Anteil ihrer Zeit außerhalb des Leerlaufs, 0 bis 1. Eine Linie nahe 1 ist eine gesättigte CPU.
- Wie es berechnet wird: Die Rate pro Sekunde von
system.cpu.timein jedem Modus außer idle, nur aus den Reihen pro CPU (denen mit einercpu.logical_number), damit keine CPU-Zeit doppelt zählt, eine Linie pro Service undcpu.logical_number, die sechzehn höchsten. Linien, ein Punkt pro Schritt über den gewählten Zeitraum. - Filter: Der Filter Service schränkt dieses Panel ein.
- Öffnet: Sein Titel öffnet die Ansicht Metric für
system.cpu.time.