El dashboard Dart Server on Linux
Un servidor Dart de un vistazo: CPU, memoria, disco y carga en indicadores; sus solicitudes, errores y latencia; el event loop; y el host y el contenedor que tiene debajo.
Para quién es: Quien opera un servidor Dart: la salud de un servidor, desde sus solicitudes hasta el host.
Ábralo desde Dashboards en el Observatory: elija Dart Server on Linux. Es un dashboard integrado, así que es de solo lectura; Save a copy crea una copia que puede modificar. Cómo cada panel lee el intervalo, sus colores y sus estados vacíos se explica en Leer un dashboard.
La barra de herramientas: los filtros Service, cada uno en All hasta que elija un valor, y el intervalo de tiempo. Cada menú enumera los valores que lleva http.server.request.duration en el intervalo. Cada panel de abajo indica los filtros que lo acotan.
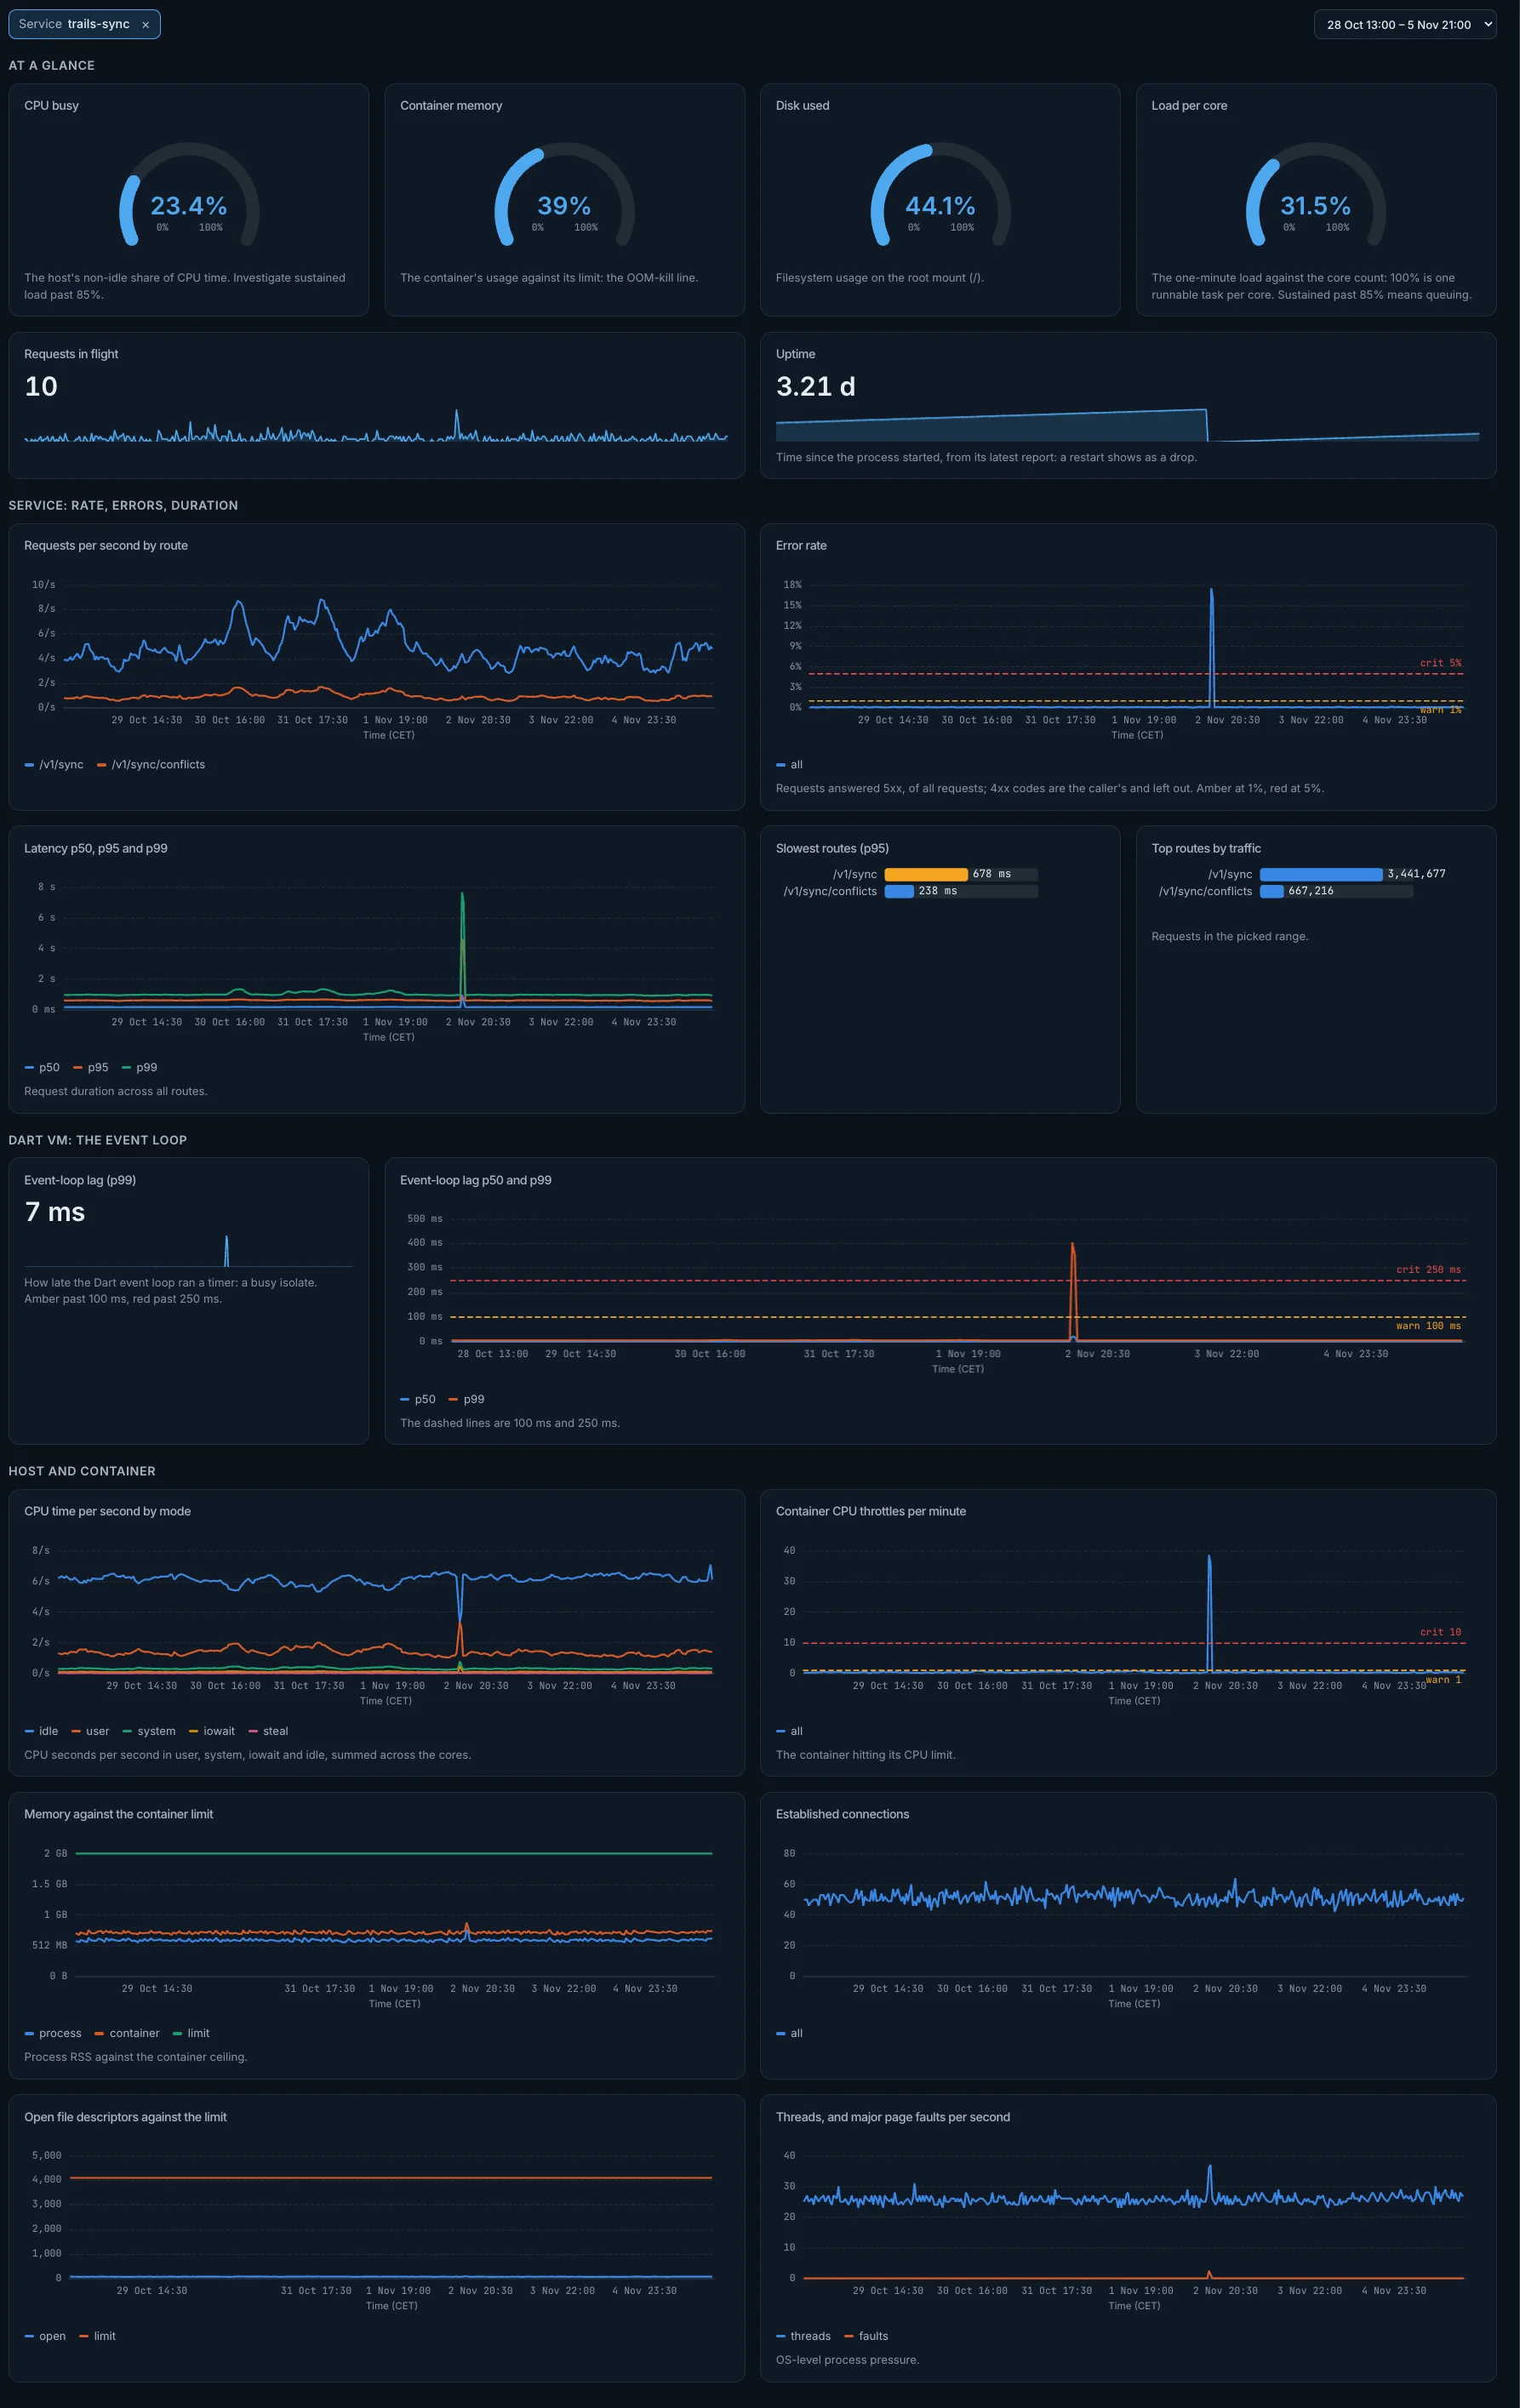
At a glance
CPU busy
La proporción del tiempo de CPU del host que no está inactivo. Investigue una carga sostenida por encima del 85 %.
- Cómo se calcula: 100 × (1 − tiempo de CPU inactivo / todo el tiempo de CPU), a partir de las tasas por segundo de
system.cpu.timeconcpu.modeidle y en todos los modos, solo de las series por CPU (las que tienen uncpu.logical_number), para que ningún tiempo de CPU cuente dos veces. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 85 % y a rojo por encima de 95 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.cpu.time.
Container memory
El uso del contenedor frente a su límite: la línea a partir de la cual el sistema lo cierra por falta de memoria (OOM).
- Cómo se calcula: El promedio de
container.memory.usagedividido por el promedio dedartastic.container.memory.limit, en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 80 % y a rojo por encima de 90 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
container.memory.usage.
Disk used
El uso del sistema de archivos en el punto de montaje raíz (/).
- Cómo se calcula:
system.filesystem.usageen el punto de montaje/en el estado used, sumado, dividido por todo elsystem.filesystem.usagede ese punto de montaje, sumado, en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 75 % y a rojo por encima de 90 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.filesystem.usage.
Load per core
La carga de un minuto frente al número de núcleos: 100 % es una tarea ejecutable por núcleo. Por encima del 85 % de forma sostenida, hay cola.
- Cómo se calcula: El promedio de
dartastic.system.cpu.load_average.1m, dividido por el número de valores distintos decpu.logical_numberensystem.cpu.time(los núcleos; la serie sumada no lleva ninguno), en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 85 % y a rojo por encima de 95 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.system.cpu.load_average.1m.
Requests in flight
Las solicitudes activas.
- Cómo se calcula:
http.server.active_requestssolo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), sumado. Un solo valor para todo el período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.active_requests.
Uptime
El tiempo desde que se inició el proceso, según su último informe: un reinicio se ve como una caída.
- Cómo se calcula: El último informe de
process.uptimesolo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí). Un solo valor para todo el período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.uptime.
Service: rate, errors, duration
Requests per second by route
Las solicitudes por segundo de cada ruta.
- Cómo se calcula: La tasa por segundo de las muestras de
http.server.request.duration, una línea porhttp.route. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.request.duration.
Error rate
Las solicitudes respondidas con 5xx, sobre todas las solicitudes; los códigos 4xx son responsabilidad de quien llama y se excluyen. Ámbar al 1 %, rojo al 5 %.
- Cómo se calcula: Las solicitudes (muestras de
http.server.request.duration) cuyohttp.response.status_codees 500 o mayor, divididas por todas las solicitudes, en porcentaje. Líneas, un punto por intervalo a lo largo del período elegido. - Colores: Unas líneas discontinuas marcan 1 % (advertencia) y 5 % (crítico).
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.request.duration.
Latency p50, p95 and p99
La duración de las solicitudes en todas las rutas.
- Cómo se calcula: Los percentiles 50, 95 y 99 de
http.server.request.duration, una línea cada uno. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.request.duration.
Slowest routes (p95)
En qué se va el presupuesto de latencia.
- Cómo se calcula: El percentil 95 de
http.server.request.durationporhttp.route, las seis principales. Barras ordenadas, cada valor para todo el período elegido. - Colores: Una barra pasa a ámbar por encima de 250 ms y a rojo por encima de 1 s.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.request.duration.
Top routes by traffic
Las solicitudes en el período elegido, por ruta.
- Cómo se calcula: El número de muestras de
http.server.request.durationporhttp.route, las seis principales. Barras ordenadas, cada valor para todo el período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
http.server.request.duration.
Dart VM: the event loop
Event-loop lag (p99)
Con cuánto retraso ejecutó un temporizador el event loop de Dart: señal de un isolate ocupado. Ámbar por encima de 100 ms, rojo por encima de 250 ms.
- Cómo se calcula: El percentil 99 de
dartastic.event_loop.lag. Un solo valor para todo el período elegido. - Mejor: Cuanto más bajo, mejor.
- Colores: El valor pasa a ámbar por encima de 100 ms y a rojo por encima de 250 ms.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.event_loop.lag.
Event-loop lag p50 and p99
Las líneas discontinuas marcan 100 ms y 250 ms.
- Cómo se calcula: Los percentiles 50 y 99 de
dartastic.event_loop.lag, una línea cada uno. Líneas, un punto por intervalo a lo largo del período elegido. - Colores: Unas líneas discontinuas marcan 100 ms (advertencia) y 250 ms (crítico).
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.event_loop.lag.
Host and container
CPU time per second by mode
Los segundos de CPU por segundo en user, system, iowait e idle, sumados entre los núcleos, así que supera 1 en un host con más de un núcleo.
- Cómo se calcula: La tasa por segundo de
system.cpu.timesolo de las series por CPU (las que tienen uncpu.logical_number), para que ningún tiempo de CPU cuente dos veces, una línea porcpu.mode. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.cpu.time.
Container CPU throttles per minute
Las veces que el contenedor alcanza su límite de CPU.
- Cómo se calcula: La tasa por minuto de
dartastic.container.cpu.throttled.count. Líneas, un punto por intervalo a lo largo del período elegido. - Colores: Unas líneas discontinuas marcan 1 (advertencia) y 10 (crítico).
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.container.cpu.throttled.count.
Memory against the container limit
El RSS del proceso frente al techo del contenedor.
- Cómo se calcula: Tres líneas: el promedio de
process.memory.usagesolo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), y los promedios decontainer.memory.usageydartastic.container.memory.limit. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.memory.usage.
Established connections
Las conexiones TCP abiertas en el estado established.
- Cómo se calcula:
system.network.connection.countconnetwork.connection.stateestablished, sumado. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.network.connection.count.
Open file descriptors against the limit
Los descriptores de archivo abiertos junto a su límite.
- Cómo se calcula: Dos líneas, solo de los procesos de servidor (los que no llevan
flutter.build.mode; el proceso de una app Flutter nunca cuenta aquí): el valor más alto deprocess.unix.file_descriptor.county el valor más alto dedartastic.process.open_file_descriptors.limit. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.unix.file_descriptor.count.
Threads, and major page faults per second
La presión sobre el proceso a nivel del sistema operativo.
- Cómo se calcula: Dos líneas, solo de los procesos de servidor (los que no llevan
flutter.build.mode; el proceso de una app Flutter nunca cuenta aquí): el valor más alto deprocess.thread.count, y la tasa por segundo deprocess.paging.faultsconsystem.paging.fault.typemajor. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.thread.count.