El dashboard Server Health
Los servidores debajo de los servicios: la carga frente a los núcleos, el margen de memoria y de descriptores, los estados de los sockets, la espera de E/S, los errores de página, el disco, la limitación de CPU y la ocupación por CPU. Cada servicio indica su host, así que Service elige un servidor.
Para quién es: Quien mantiene los servidores en marcha: capacidad, margen y presión.
Ábralo desde Dashboards en el Observatory: elija Server Health. Es un dashboard integrado, así que es de solo lectura; Save a copy crea una copia que puede modificar. Cómo cada panel lee el intervalo, sus colores y sus estados vacíos se explica en Leer un dashboard.
La barra de herramientas: los filtros Service, cada uno en All hasta que elija un valor, y el intervalo de tiempo. Cada menú enumera los valores que lleva system.cpu.time en el intervalo. Cada panel de abajo indica los filtros que lo acotan.
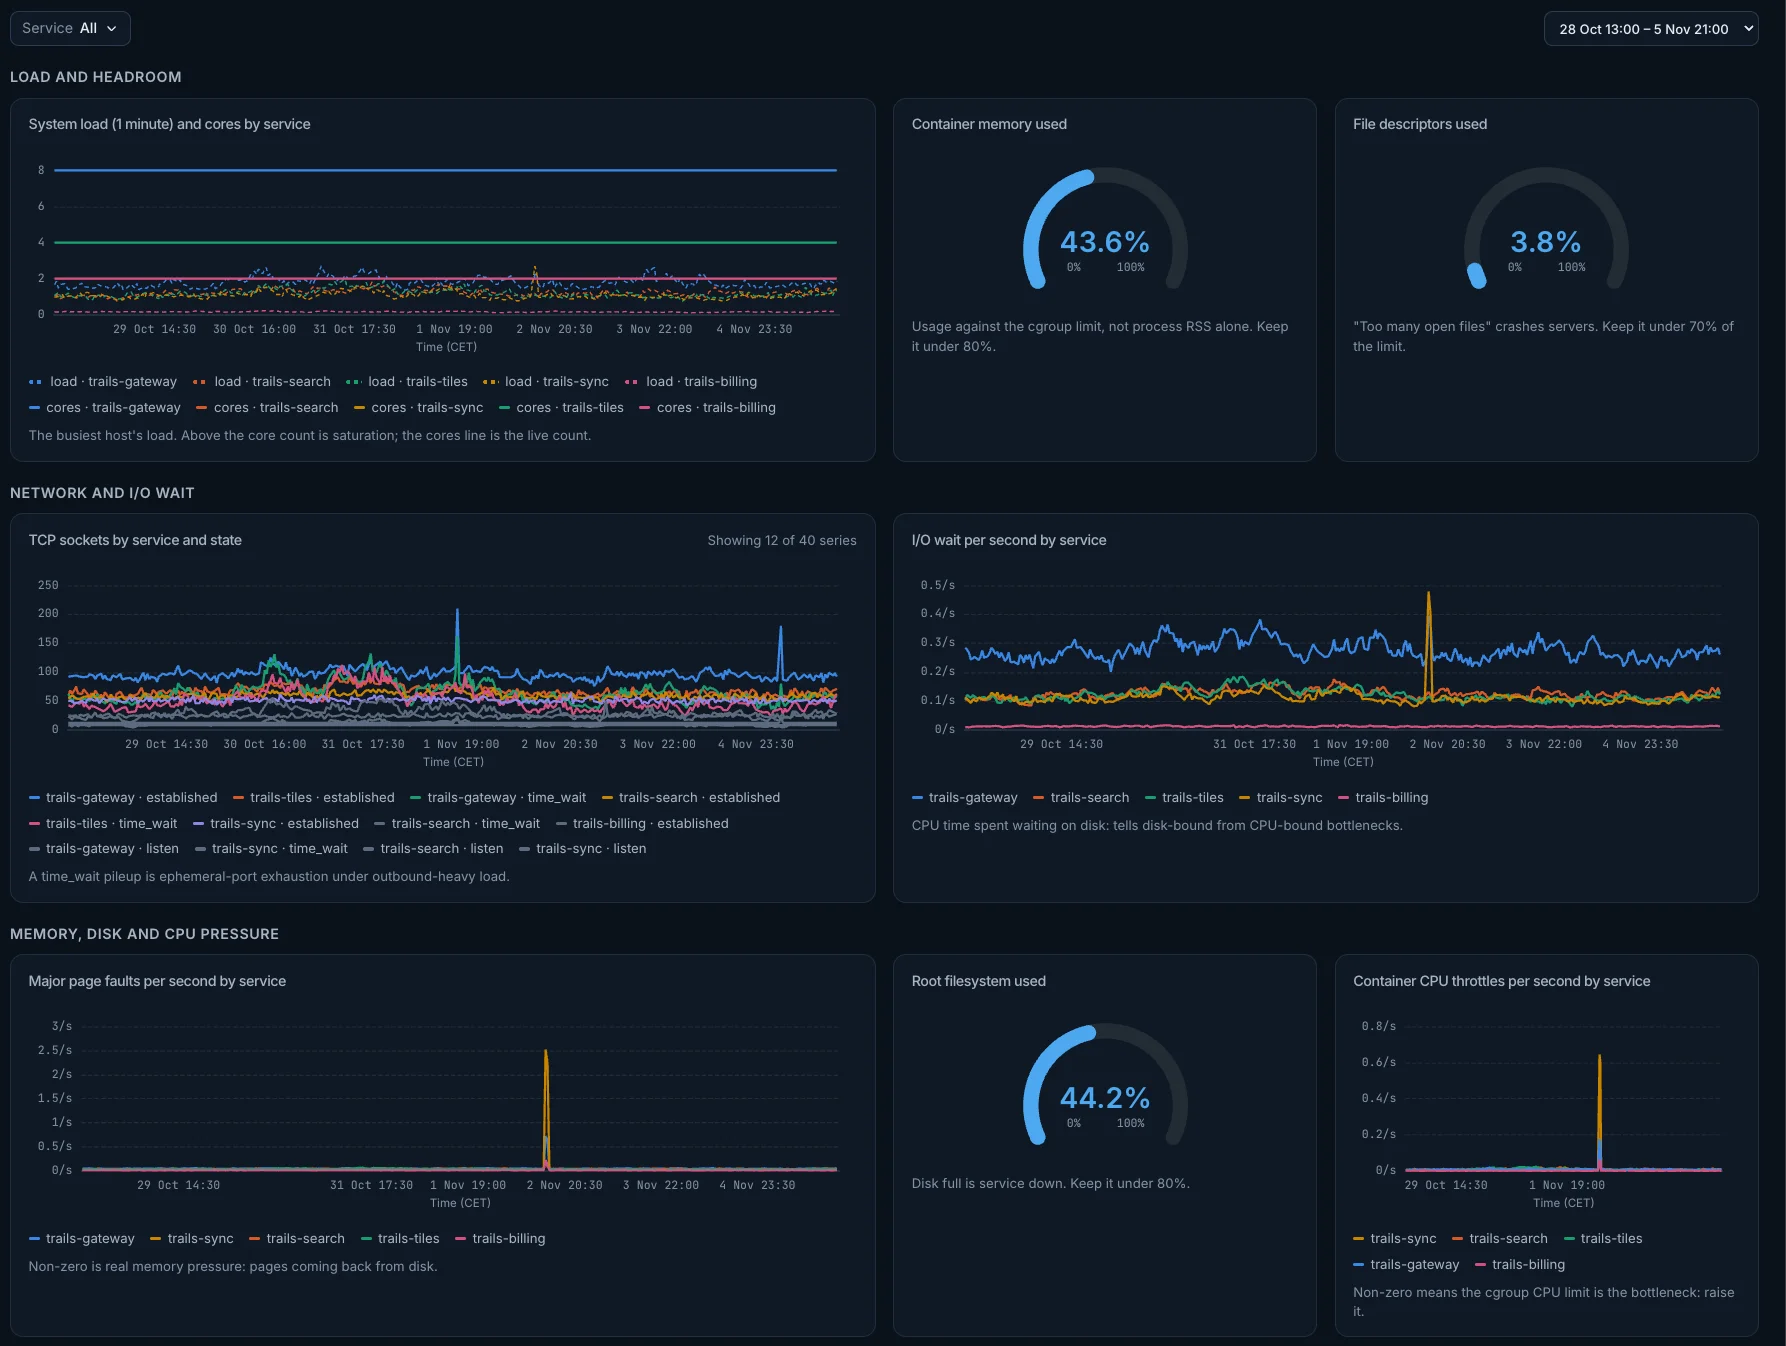
Load and headroom
System load (1 minute) and cores by service
La carga del host más ocupado. Por encima del número de núcleos hay saturación; la línea de núcleos es el recuento en vivo.
- Cómo se calcula: Dos líneas por servicio: el valor más alto de
dartastic.system.cpu.load_average.1mentre sus hosts, y el número de valores distintos decpu.logical_numberensystem.cpu.time(los núcleos; la serie sumada no lleva ninguno). Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.system.cpu.load_average.1m.
Container memory used
El uso frente al límite del cgroup, no solo el RSS del proceso. Manténgalo por debajo del 80 %.
- Cómo se calcula: El valor más alto de
container.memory.usagedividido por el valor más alto dedartastic.container.memory.limit, en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 80 % y a rojo por encima de 95 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
container.memory.usage.
File descriptors used
“Too many open files” tumba servidores. Manténgalo por debajo del 70 % del límite.
- Cómo se calcula: El valor más alto de
process.unix.file_descriptor.countdividido por el valor más alto dedartastic.process.open_file_descriptors.limit, solo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 70 % y a rojo por encima de 90 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.unix.file_descriptor.count.
Network and I/O wait
TCP sockets by service and state
Una acumulación en time_wait es el agotamiento de puertos efímeros bajo una carga con mucho tráfico saliente.
- Cómo se calcula:
system.network.connection.count, sumado, una línea por servicio ynetwork.connection.state, las doce principales. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.network.connection.count.
I/O wait per second by service
El tiempo de CPU dedicado a esperar al disco: distingue los cuellos de botella de disco de los de CPU.
- Cómo se calcula: La tasa por segundo de
system.cpu.timeconcpu.modeiowait, solo de las series por CPU (las que tienen uncpu.logical_number), para que ningún tiempo de CPU cuente dos veces, una línea por servicio. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.cpu.time.
Memory, disk and CPU pressure
Major page faults per second by service
Un valor distinto de cero es presión de memoria real: páginas que vuelven del disco.
- Cómo se calcula: La tasa por segundo de
process.paging.faultsconsystem.paging.fault.typemajor, solo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), una línea por servicio. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.paging.faults.
Root filesystem used
Disco lleno es servicio caído. Manténgalo por debajo del 80 %.
- Cómo se calcula:
system.filesystem.usageen el punto de montaje/en el estado used, sumado, dividido por todo elsystem.filesystem.usagede ese punto de montaje, sumado, en porcentaje. Un indicador de 0 a 100 %, un solo valor para todo el período elegido. - Colores: El indicador pasa a ámbar por encima de 80 % y a rojo por encima de 90 %.
- Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.filesystem.usage.
Container CPU throttles per second by service
Un valor distinto de cero significa que el límite de CPU del cgroup es el cuello de botella: súbalo.
- Cómo se calcula: La tasa por segundo de
dartastic.container.cpu.throttled.count, una línea por servicio. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
dartastic.container.cpu.throttled.count.
Processes and per-CPU
Process CPU time per second by service and mode
El tiempo de CPU que usa el proceso de cada servicio, por modo.
- Cómo se calcula: La tasa por segundo de
process.cpu.timesolo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), una línea por servicio ycpu.mode. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.cpu.time.
Process uptime by service
El tiempo desde que se inició cada proceso: un valor bajo es un reinicio reciente.
- Cómo se calcula: Uptime: el último informe de
process.uptimepor servicio, solo de los procesos de servidor (los que no llevanflutter.build.mode; el proceso de una app Flutter nunca cuenta aquí), los veinte principales. Una tabla, cada valor para todo el período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
process.uptime.
Busy share of each CPU by service
Cada línea es una CPU de un host: la proporción de su tiempo fuera de idle, de 0 a 1. Una línea cerca de 1 es una CPU saturada.
- Cómo se calcula: La tasa por segundo de
system.cpu.timeen todos los modos salvo idle, solo de las series por CPU (las que tienen uncpu.logical_number), para que ningún tiempo de CPU cuente dos veces, una línea por servicio ycpu.logical_number, las dieciséis principales. Líneas, un punto por intervalo a lo largo del período elegido. - Filtros: El filtro Service acota este panel.
- Abre: su título abre la pantalla Metric en
system.cpu.time.