Le tableau de bord Server Health
Les serveurs sous les services : charge par rapport aux cœurs, marge de mémoire et de descripteurs, états des sockets, attente d’E/S, défauts de page, disque, bridage CPU et occupation par CPU. Chaque service nomme son hôte : Service choisit donc un serveur.
Pour qui : Pour quiconque maintient les serveurs en service : capacité, marge et pression.
Ouvrez-le depuis Dashboards dans l’Observatory : choisissez Server Health. C’est un tableau de bord intégré, donc en lecture seule ; Save a copy en crée une copie que vous pouvez modifier. La façon dont chaque panneau lit la plage de temps, ses couleurs et ses états vides est décrite dans Lire un tableau de bord.
La barre d’outils : les filtres Service, chacun sur All tant que vous n’avez pas choisi de valeur, et la plage de temps. Chaque menu liste les valeurs que porte system.cpu.time sur la plage. Chaque panneau ci-dessous indique les filtres qui le restreignent.
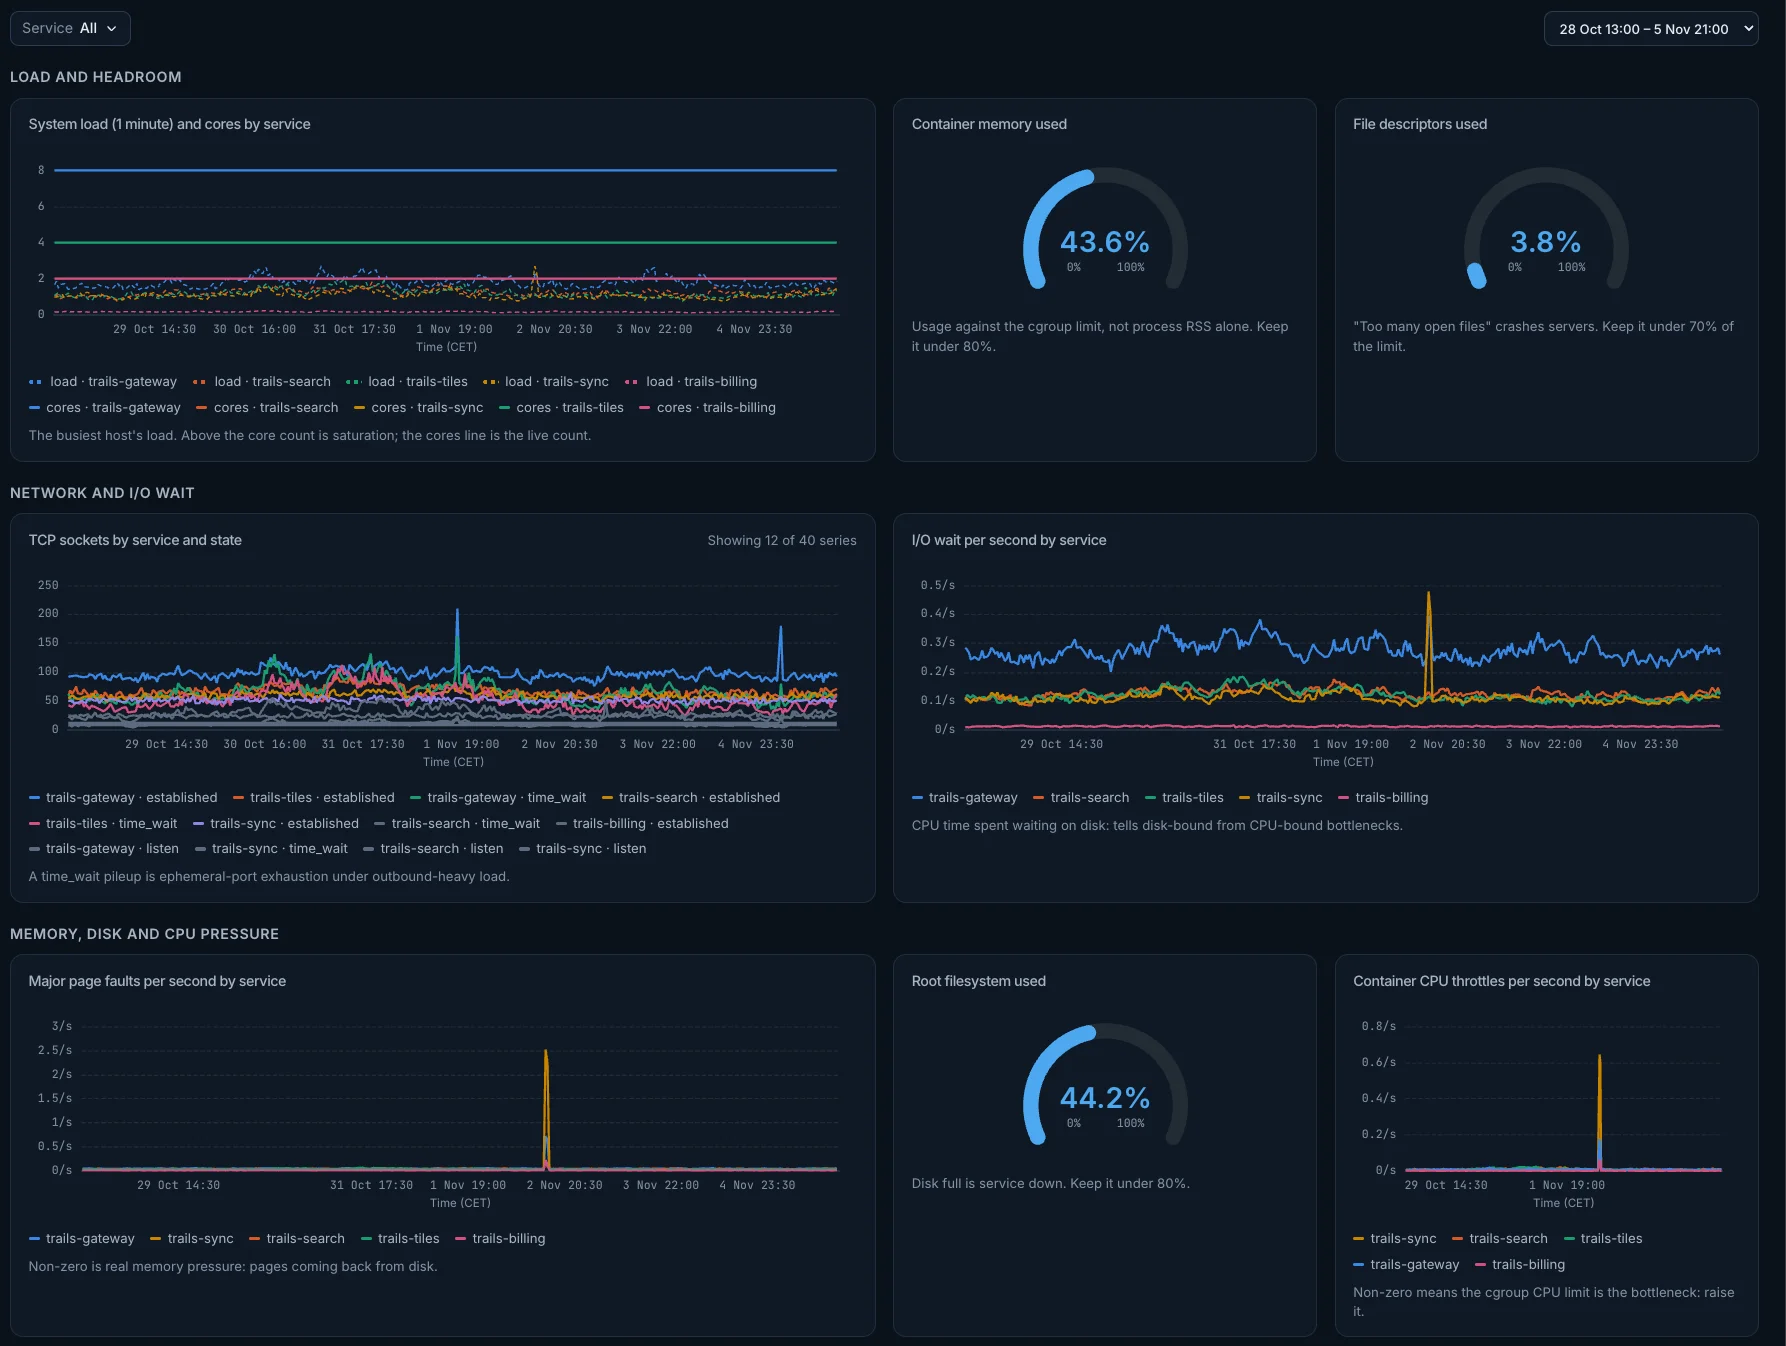
Load and headroom
System load (1 minute) and cores by service
La charge de l’hôte le plus occupé. Au-dessus du nombre de cœurs, c’est la saturation ; la ligne des cœurs donne le nombre réel.
- Calcul : Deux courbes par service : la valeur la plus haute de
dartastic.system.cpu.load_average.1mparmi ses hôtes, et le nombre de valeurs distinctes decpu.logical_numbersursystem.cpu.time(les cœurs ; la série agrégée n’en porte pas). Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
dartastic.system.cpu.load_average.1m.
Container memory used
L’utilisation par rapport à la limite du cgroup, pas le seul RSS du processus. Restez sous 80 %.
- Calcul : La valeur la plus haute de
container.memory.usagedivisée par la valeur la plus haute dedartastic.container.memory.limit, affichée en pourcentage. Un cadran de 0 à 100 %, une seule valeur pour toute la période choisie. - Couleurs : Le cadran passe à l’orange au-dessus de 80 % et au rouge au-dessus de 95 %.
- Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
container.memory.usage.
File descriptors used
« Too many open files » fait tomber les serveurs. Restez sous 70 % de la limite.
- Calcul : La valeur la plus haute de
process.unix.file_descriptor.countdivisée par la valeur la plus haute dedartastic.process.open_file_descriptors.limit, des seuls processus serveur (ceux sansflutter.build.mode; le processus d’une application Flutter n’est jamais compté ici), affichée en pourcentage. Un cadran de 0 à 100 %, une seule valeur pour toute la période choisie. - Couleurs : Le cadran passe à l’orange au-dessus de 70 % et au rouge au-dessus de 90 %.
- Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
process.unix.file_descriptor.count.
Network and I/O wait
TCP sockets by service and state
Une accumulation de time_wait signale l’épuisement des ports éphémères sous une forte charge sortante.
- Calcul :
system.network.connection.count, additionné, une courbe par service et parnetwork.connection.state, les douze premiers. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
system.network.connection.count.
I/O wait per second by service
Le temps CPU passé à attendre le disque : il distingue les goulots d’étranglement liés au disque de ceux liés au CPU.
- Calcul : Le taux par seconde de
system.cpu.timeaveccpu.modeiowait, à partir des seules séries par CPU (celles qui ont uncpu.logical_number), afin qu’aucun temps CPU ne compte deux fois, une courbe par service. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
system.cpu.time.
Memory, disk and CPU pressure
Major page faults per second by service
Une valeur non nulle traduit une vraie pression mémoire : des pages qui reviennent du disque.
- Calcul : Le taux par seconde de
process.paging.faultsavecsystem.paging.fault.typemajor, des seuls processus serveur (ceux sansflutter.build.mode; le processus d’une application Flutter n’est jamais compté ici), une courbe par service. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
process.paging.faults.
Root filesystem used
Disque plein, service à l’arrêt. Restez sous 80 %.
- Calcul :
system.filesystem.usagesur le point de montage/dans l’état used, additionné, divisé par la somme de toutsystem.filesystem.usagede ce point de montage, affiché en pourcentage. Un cadran de 0 à 100 %, une seule valeur pour toute la période choisie. - Couleurs : Le cadran passe à l’orange au-dessus de 80 % et au rouge au-dessus de 90 %.
- Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
system.filesystem.usage.
Container CPU throttles per second by service
Une valeur non nulle signifie que la limite CPU du cgroup est le goulot d’étranglement : relevez-la.
- Calcul : Le taux par seconde de
dartastic.container.cpu.throttled.count, une courbe par service. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
dartastic.container.cpu.throttled.count.
Processes and per-CPU
Process CPU time per second by service and mode
Le temps CPU qu’utilise le processus de chaque service, par mode.
- Calcul : Le taux par seconde de
process.cpu.timedes seuls processus serveur (ceux sansflutter.build.mode; le processus d’une application Flutter n’est jamais compté ici), une courbe par service et parcpu.mode. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
process.cpu.time.
Process uptime by service
Le temps écoulé depuis le démarrage de chaque processus : une valeur faible signale un redémarrage récent.
- Calcul : Uptime : le dernier relevé de
process.uptimepar service, des seuls processus serveur (ceux sansflutter.build.mode; le processus d’une application Flutter n’est jamais compté ici), les vingt premiers. Un tableau, chaque valeur portant sur toute la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
process.uptime.
Busy share of each CPU by service
Chaque courbe est un CPU d’un hôte : la part de son temps hors inactivité, de 0 à 1. Une courbe proche de 1 est un CPU saturé.
- Calcul : Le taux par seconde de
system.cpu.timedans tous les modes sauf idle, à partir des seules séries par CPU (celles qui ont uncpu.logical_number), afin qu’aucun temps CPU ne compte deux fois, une courbe par service et parcpu.logical_number, les seize premiers. Des courbes, un point par intervalle sur la période choisie. - Filtres : Le filtre Service restreint ce panneau.
- Ouvre : son titre ouvre l’écran Metric sur
system.cpu.time.