Service Overviewダッシュボード
すべてのDartサービスのリクエスト、エラー、レイテンシー、選択したサービスのオペレーションとレイテンシーの分布、ステータスコードの内訳を示します。
対象: アプリの背後にあるDartサービスを運用する人:オンコールのエンジニアとバックエンドの担当者。
Observatoryの「Dashboards」から「Service Overview」を選んで開きます。組み込みのダッシュボードなので読み取り専用です。「Save a copy」で、編集できるコピーを作成できます。各パネルでの期間の扱い、色、データがないときの表示については、ダッシュボードの見方を参照してください。
ツールバー:フィルター(Service。値を選ぶまでは、それぞれ「All」)と期間。各メニューには、その期間にhttp.server.request.durationが持つ値が表示されます。下の各パネルには、そのパネルを絞り込むフィルターを記載しています。
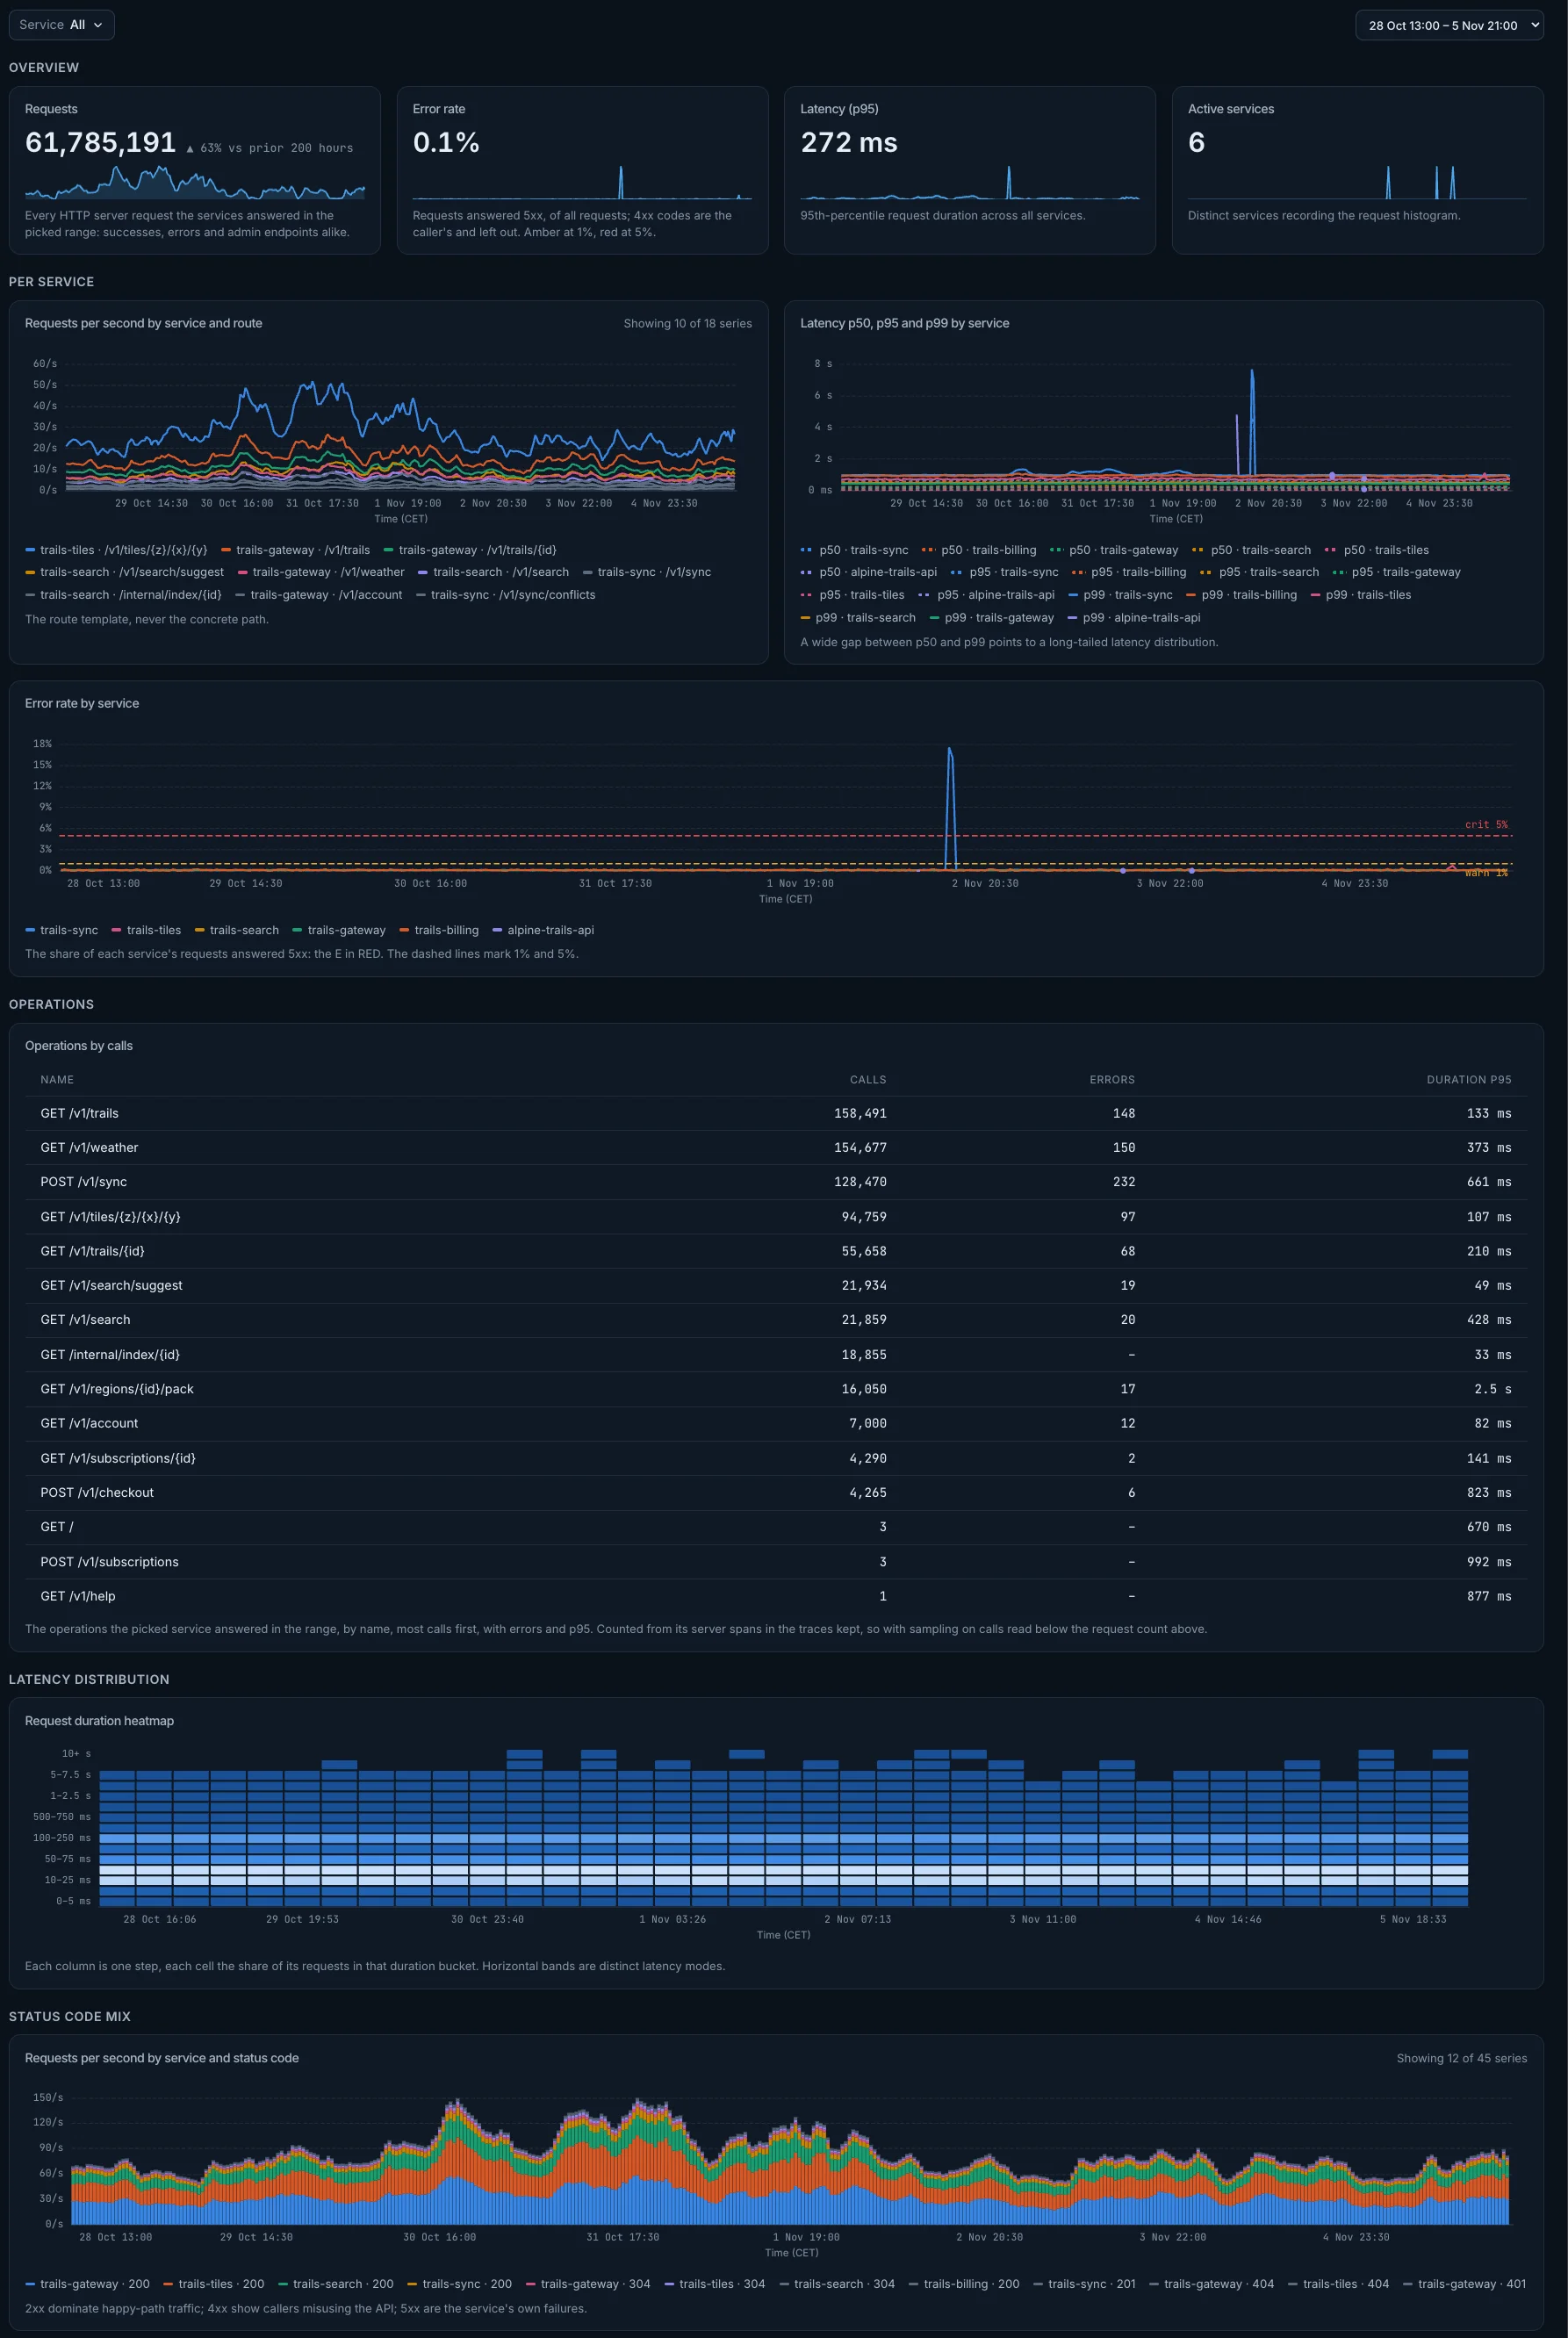
Overview
Requests
選択した期間にサービスが応答したすべてのHTTPサーバーリクエストです。成功、エラー、管理用エンドポイントをすべて含みます。
- 計算方法:
http.server.request.durationのサンプル数。 選択した期間全体を1つの値で示します。 - 比較: 値の横に、同じ長さの直前の期間からの変化を示します。
- フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Error rate
すべてのリクエストのうち、5xxで応答したものの割合です。4xxは呼び出し側の問題なので除きます。1%で黄色、5%で赤になります。
- 計算方法:
http.response.status_codeが500以上のリクエスト(http.server.request.durationのサンプル)を、すべてのリクエストで割った値(パーセント表示)。 選択した期間全体を1つの値で示します。 - 良い方向: 低いほど良好です。
- 色: 値は1%を超えると黄色、5%を超えると赤になります。
- フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Latency (p95)
すべてのサービスにわたるリクエスト時間の95パーセンタイルです。
- 計算方法:
http.server.request.durationの95パーセンタイル。 選択した期間全体を1つの値で示します。 - 良い方向: 低いほど良好です。
- 色: 値は500msを超えると黄色、2秒を超えると赤になります。
- フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Active services
リクエストのヒストグラムを記録しているサービスです。
- 計算方法:
http.server.request.durationにおける、重複しないservice.nameの数。 選択した期間全体を1つの値で示します。 - フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Per service
Requests per second by service and route
サービスとルートごとの1秒あたりのリクエスト数です。ルートはテンプレートで、具体的なパスではありません。
- 計算方法:
http.server.request.durationのサンプルの毎秒の発生率を、service.nameとhttp.routeごとに1本の線で示します。上位10件。 折れ線グラフで、選択した期間をステップごとに1点ずつ示します。 - フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Latency p50, p95 and p99 by service
p50とp99の差が大きい場合は、レイテンシーの分布が長いテールを持っていることを示します。
- 計算方法:
http.server.request.durationの50、95、99パーセンタイルを、パーセンタイルとサービスごとに1本の線で示します。 折れ線グラフで、選択した期間をステップごとに1点ずつ示します。 - フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Error rate by service
各サービスのリクエストのうち、5xxで応答したものの割合で、REDメソッドのE(Errors)にあたります。破線は1%と5%を示します。
- 計算方法:
http.response.status_codeが500以上のリクエスト(http.server.request.durationのサンプル)を、サービスごとにすべてのリクエストで割った値(パーセント表示)。 折れ線グラフで、選択した期間をステップごとに1点ずつ示します。 - 色: 破線で1%(警告)、5%(重大)を示します。
- フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Operations
Operations by calls
選択したサービスがこの期間に応答したオペレーションを、名前ごとに呼び出し数の多い順で、エラーとp95とともに示します。保持されたトレースのサーバースパンから数えるため、サンプリングが有効な場合は呼び出し数がRequestsより少なくなります。サーバースパンのみを対象にするため、ServiceをAllにしても、端末のタップやリクエストはオペレーションに含まれません。
- 計算方法: Calls:スパン名ごとのサーバースパン(スパンの種類がserver)の数。上位20件。Errors:そのうちエラーで終了したもの。Duration p95:その所要時間の95パーセンタイル。 表形式で、すべての値は選択した期間全体のものです。
- フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから「Traces」が開きます。
Latency distribution
Request duration heatmap
各列が1ステップ、各セルがその所要時間のバケットに入るリクエストの割合です。横方向の帯は、それぞれ異なるレイテンシーのモードを表します。
- 計算方法:
http.server.request.durationのバケット。各列は、そのステップのリクエストが各バケットに占める割合です。 選択した期間を36列に分けたヒートマップで、各列の幅は1分以上です。 - フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。
Status code mix
Requests per second by service and status code
正常系のトラフィックでは2xxが大半を占めます。4xxは呼び出し側のAPIの誤用を、5xxはサービス自身の障害を示します。
- 計算方法:
http.server.request.durationのサンプルの毎秒の発生率を、service.nameとhttp.response.status_codeごとに1つの区分として積み上げたもの。上位12件。 積み上げ棒グラフで、選択した期間をステップごとに1本ずつ示します。 - フィルター: Serviceのフィルターで絞り込めます。
- 開く画面: タイトルから、
http.server.request.durationの「Metric」画面が開きます。