Dashboard Server Health
Serwery pod usługami: obciążenie względem rdzeni, zapas pamięci i deskryptorów, stany gniazd, oczekiwanie na I/O, błędy stron, dysk, ograniczanie CPU i zajętość każdego procesora. Każda usługa podaje swój host, więc Service wybiera serwer.
Dla kogo: Dla każdego, kto dba o działanie serwerów: pojemność, zapas i presja.
Otwiera się go w Observatory z Dashboards: należy wybrać Server Health. To wbudowany dashboard, więc jest tylko do odczytu; Save a copy tworzy kopię, którą można zmieniać. Jak każdy panel odczytuje zakres czasu, jakie ma kolory i co pokazuje bez danych, opisuje strona Czytanie dashboardu.
Pasek narzędzi: filtry Service, każdy ustawiony na All, dopóki nie wybierze się wartości, oraz zakres czasu. Każde menu wymienia wartości, które system.cpu.time ma w danym zakresie. Każdy panel poniżej wymienia filtry, które go zawężają.
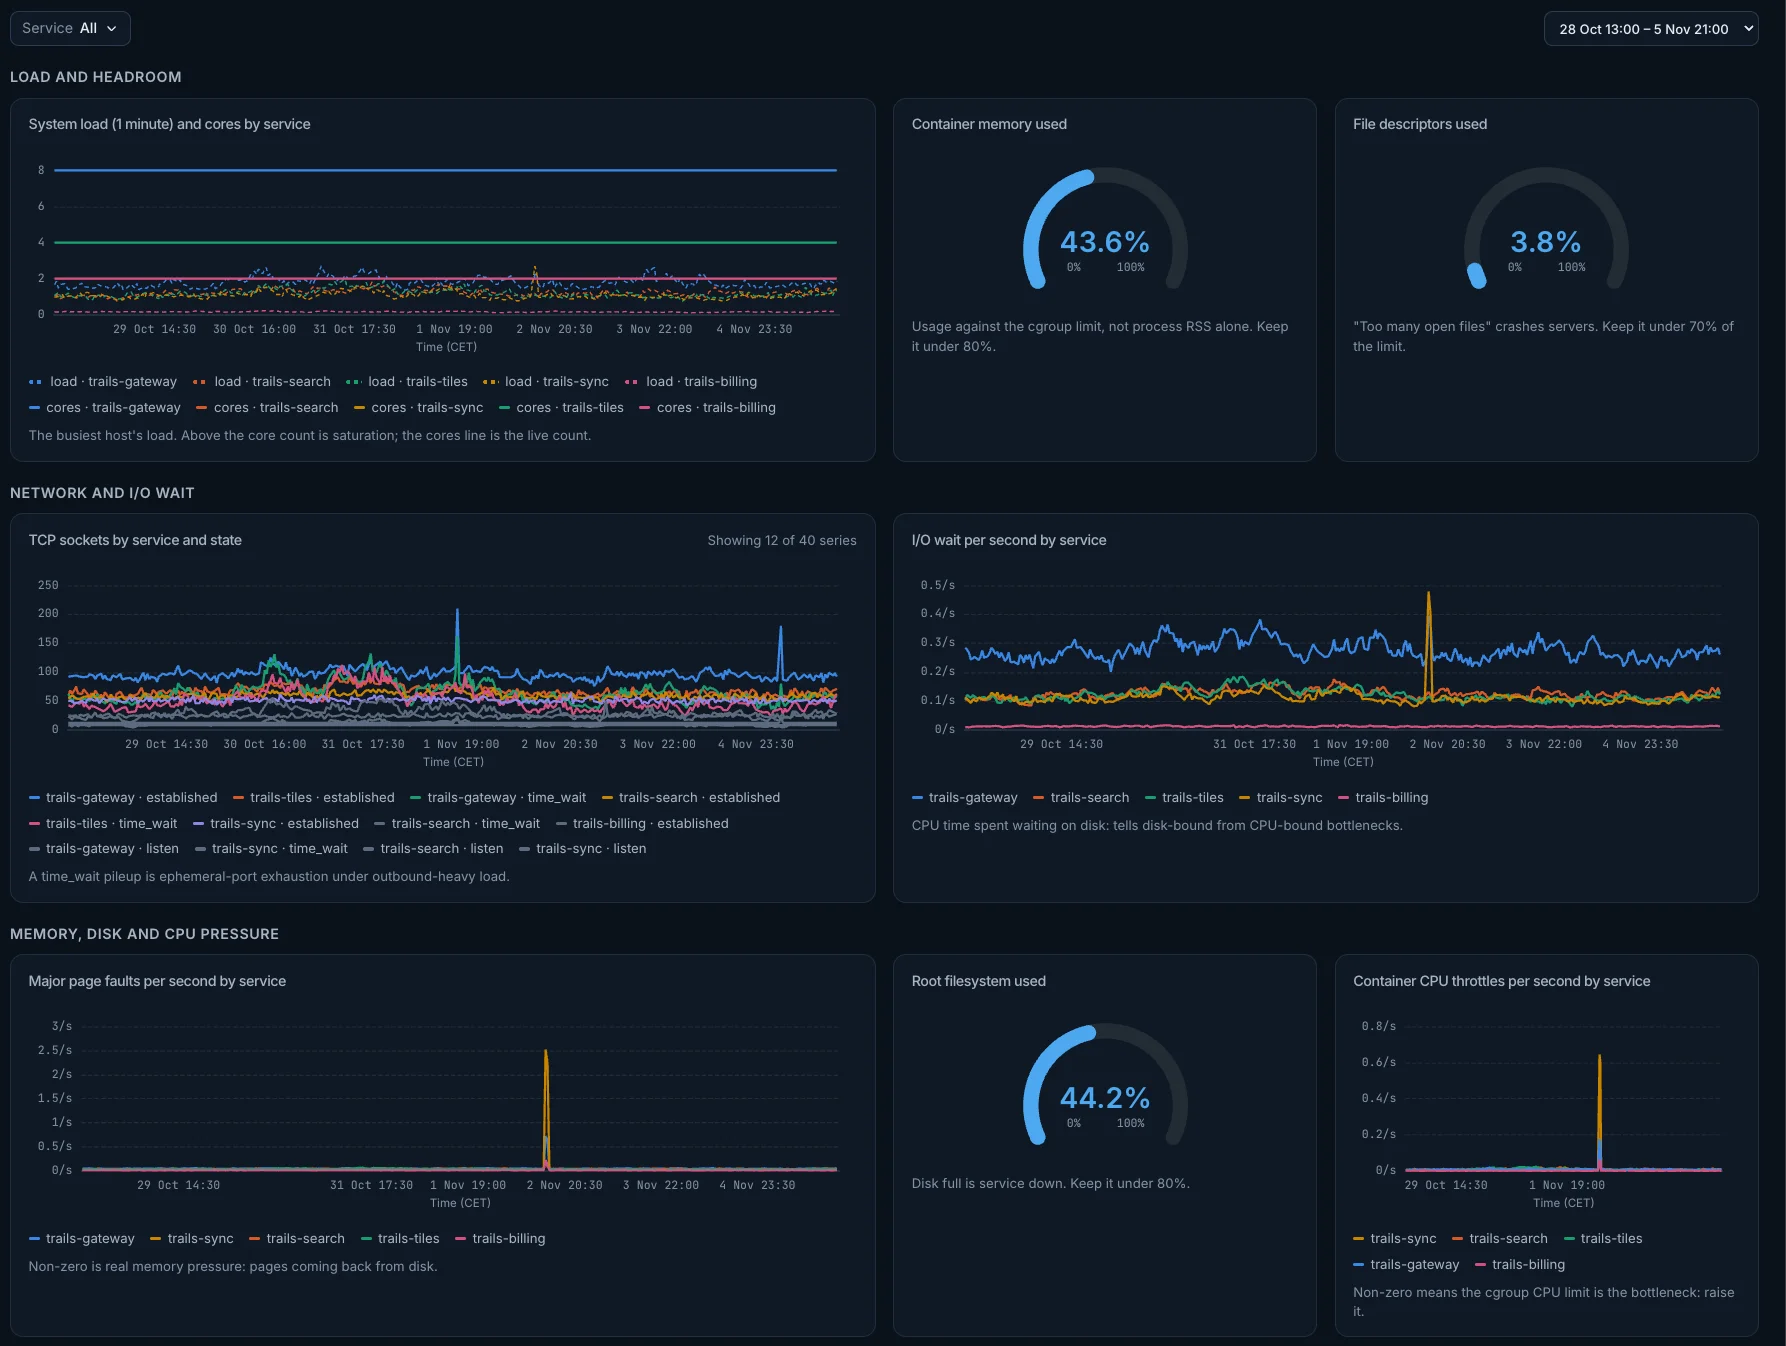
Load and headroom
System load (1 minute) and cores by service
Obciążenie najbardziej zajętego hosta. Powyżej liczby rdzeni oznacza nasycenie; linia rdzeni pokazuje ich bieżącą liczbę.
- Jak jest obliczany: Dwie linie dla każdej usługi: najwyższe
dartastic.system.cpu.load_average.1mspośród jej hostów oraz liczba unikalnych wartościcpu.logical_numberwsystem.cpu.time(rdzenie; seria zsumowana ich nie ma). Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
dartastic.system.cpu.load_average.1m.
Container memory used
Użycie względem limitu cgroup, a nie samo RSS procesu. Warto utrzymać je poniżej 80%.
- Jak jest obliczany: Najwyższe
container.memory.usagepodzielone przez najwyższedartastic.container.memory.limit, pokazane w procentach. Tarcza od 0 do 100%, jedna wartość dla całego wybranego okresu. - Kolory: Tarcza zmienia kolor na pomarańczowy powyżej 80% i na czerwony powyżej 95%.
- Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
container.memory.usage.
File descriptors used
Błąd „Too many open files” powoduje awarie serwerów. Warto utrzymać tę wartość poniżej 70% limitu.
- Jak jest obliczany: Najwyższe
process.unix.file_descriptor.countpodzielone przez najwyższedartastic.process.open_file_descriptors.limit, tylko z procesów serwera (tych bezflutter.build.mode; proces aplikacji Flutter nigdy się tu nie wlicza), pokazane w procentach. Tarcza od 0 do 100%, jedna wartość dla całego wybranego okresu. - Kolory: Tarcza zmienia kolor na pomarańczowy powyżej 70% i na czerwony powyżej 90%.
- Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
process.unix.file_descriptor.count.
Network and I/O wait
TCP sockets by service and state
Nagromadzenie gniazd w stanie time_wait oznacza wyczerpywanie portów efemerycznych przy dużym ruchu wychodzącym.
- Jak jest obliczany:
system.network.connection.count, zsumowane, jedna linia dla każdej usługi inetwork.connection.state, dwanaście największych. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
system.network.connection.count.
I/O wait per second by service
Czas CPU spędzony na czekaniu na dysk: pozwala odróżnić wąskie gardła dysku od wąskich gardeł CPU.
- Jak jest obliczany: Częstość na sekundę
system.cpu.timezcpu.modeiowait, tylko z serii dla poszczególnych procesorów (tych zcpu.logical_number), więc żaden czas CPU nie liczy się dwa razy, jedna linia dla każdej usługi. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
system.cpu.time.
Memory, disk and CPU pressure
Major page faults per second by service
Wartość niezerowa oznacza rzeczywistą presję pamięci: strony wracają z dysku.
- Jak jest obliczany: Częstość na sekundę
process.paging.faultszsystem.paging.fault.typemajor, tylko z procesów serwera (tych bezflutter.build.mode; proces aplikacji Flutter nigdy się tu nie wlicza), jedna linia dla każdej usługi. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
process.paging.faults.
Root filesystem used
Pełny dysk to niedziałająca usługa. Warto utrzymać tę wartość poniżej 80%.
- Jak jest obliczany:
system.filesystem.usagew punkcie montowania/w stanie used, zsumowane, podzielone przez całesystem.filesystem.usagetego punktu montowania, zsumowane, pokazane w procentach. Tarcza od 0 do 100%, jedna wartość dla całego wybranego okresu. - Kolory: Tarcza zmienia kolor na pomarańczowy powyżej 80% i na czerwony powyżej 90%.
- Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
system.filesystem.usage.
Container CPU throttles per second by service
Wartość niezerowa oznacza, że wąskim gardłem jest limit CPU w cgroup: należy go podnieść.
- Jak jest obliczany: Częstość na sekundę
dartastic.container.cpu.throttled.count, jedna linia dla każdej usługi. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
dartastic.container.cpu.throttled.count.
Processes and per-CPU
Process CPU time per second by service and mode
Czas CPU zużywany przez proces każdej usługi, według trybu.
- Jak jest obliczany: Częstość na sekundę
process.cpu.timetylko z procesów serwera (tych bezflutter.build.mode; proces aplikacji Flutter nigdy się tu nie wlicza), jedna linia dla każdej usługi icpu.mode. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
process.cpu.time.
Process uptime by service
Czas od startu każdego procesu: niska wartość oznacza niedawny restart.
- Jak jest obliczany: Uptime: ostatni raport
process.uptimedla każdej usługi, tylko z procesów serwera (tych bezflutter.build.mode; proces aplikacji Flutter nigdy się tu nie wlicza), dwadzieścia największych. Tabela, każda wartość dla całego wybranego okresu. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
process.uptime.
Busy share of each CPU by service
Każda linia to jeden procesor jednego hosta: część jego czasu poza stanem idle, od 0 do 1. Linia bliska 1 oznacza nasycony procesor.
- Jak jest obliczany: Częstość na sekundę
system.cpu.timewe wszystkich trybach poza idle, tylko z serii dla poszczególnych procesorów (tych zcpu.logical_number), więc żaden czas CPU nie liczy się dwa razy, jedna linia dla każdej usługi icpu.logical_number, szesnaście największych. Linie, jeden punkt na krok w całym wybranym okresie. - Filtry: Filtr Service zawęża ten panel.
- Otwiera: jego tytuł otwiera ekran Metric dla
system.cpu.time.