O dashboard Server Health
Os servidores por baixo dos serviços: carga diante dos núcleos, folga de memória e de descritores, estados dos sockets, espera de I/O, page faults, disco, throttling de CPU e ocupação por CPU. Cada serviço informa o seu host, então Service escolhe um servidor.
Para quem é: Quem mantém os servidores no ar: capacidade, folga e pressão.
Abra-o em Dashboards no Observatory: escolha Server Health. É um dashboard integrado, então é somente leitura; Save a copy cria uma cópia que você pode alterar. Como cada painel lê o intervalo de tempo, suas cores e seus estados vazios estão em Como ler um dashboard.
A barra de ferramentas: os filtros Service, cada um em All até você escolher um valor, e o intervalo de tempo. Cada menu lista os valores que system.cpu.time traz no intervalo. Cada painel abaixo indica os filtros que o restringem.
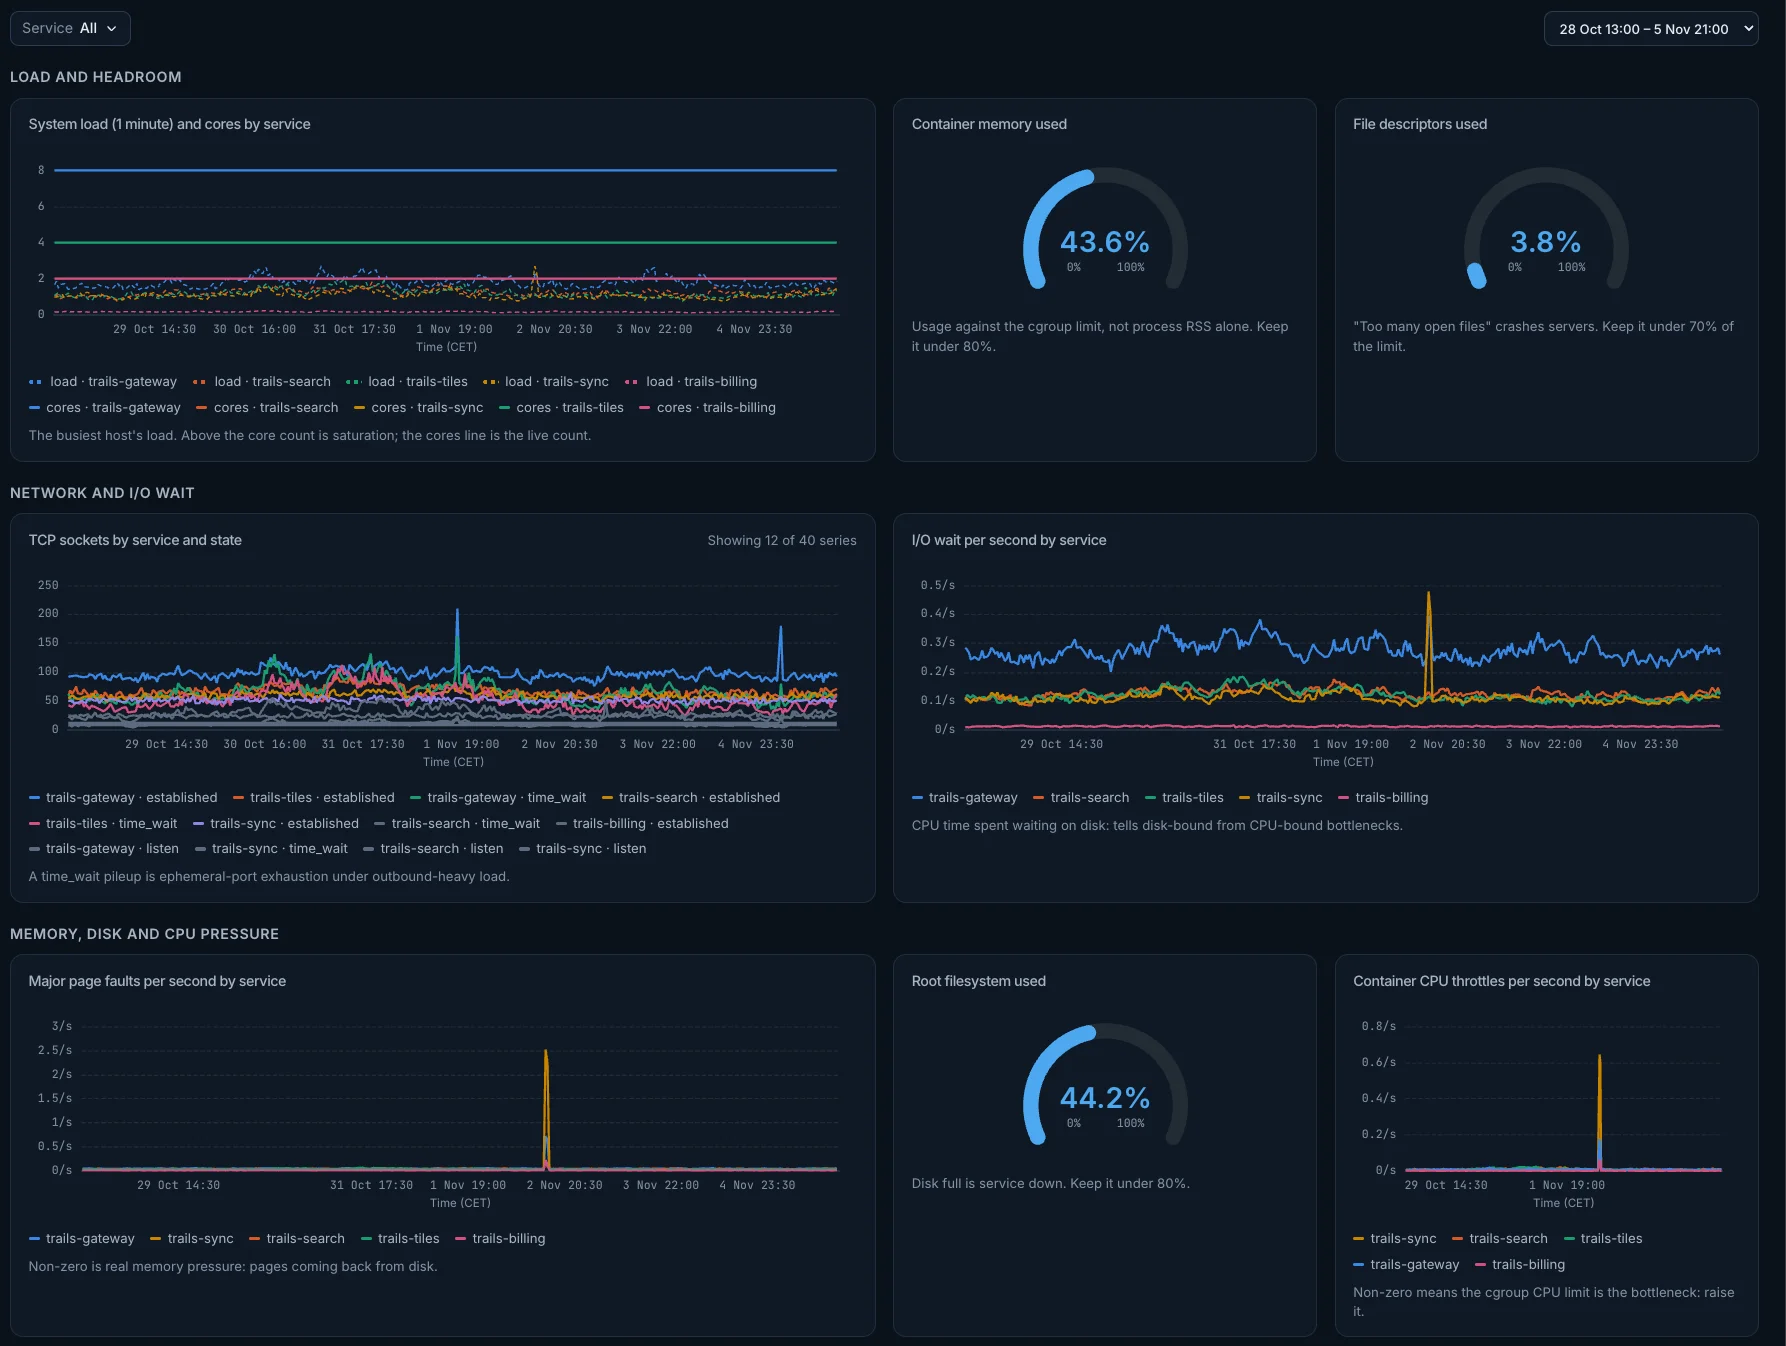
Load and headroom
System load (1 minute) and cores by service
A carga do host mais ocupado. Acima do número de núcleos é saturação; a linha dos núcleos é a contagem atual.
- Como é calculado: Duas linhas por serviço: o maior
dartastic.system.cpu.load_average.1mdos seus hosts e o número de valores distintos decpu.logical_numberemsystem.cpu.time(os núcleos; a série somada não traz nenhum). Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
dartastic.system.cpu.load_average.1m.
Container memory used
O uso diante do limite do cgroup, não só o RSS do processo. Mantenha abaixo de 80%.
- Como é calculado: O maior
container.memory.usagedividido pelo maiordartastic.container.memory.limit, mostrado em porcentagem. Um medidor de 0 a 100%, um único valor para todo o período escolhido. - Cores: O medidor fica âmbar acima de 80% e vermelho acima de 95%.
- Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
container.memory.usage.
File descriptors used
“Too many open files” derruba servidores. Mantenha abaixo de 70% do limite.
- Como é calculado: O maior
process.unix.file_descriptor.countdividido pelo maiordartastic.process.open_file_descriptors.limit, só dos processos de servidor (os que não têmflutter.build.mode; o processo de um app Flutter nunca entra aqui), mostrado em porcentagem. Um medidor de 0 a 100%, um único valor para todo o período escolhido. - Cores: O medidor fica âmbar acima de 70% e vermelho acima de 90%.
- Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
process.unix.file_descriptor.count.
Network and I/O wait
TCP sockets by service and state
Um acúmulo de time_wait é esgotamento de portas efêmeras sob carga com muito tráfego de saída.
- Como é calculado:
system.network.connection.count, somado, uma linha por serviço enetwork.connection.state, as doze principais. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
system.network.connection.count.
I/O wait per second by service
Tempo de CPU gasto esperando o disco: distingue gargalos de disco de gargalos de CPU.
- Como é calculado: A taxa por segundo de
system.cpu.timecomcpu.modeiowait, só das séries por CPU (as que têm umcpu.logical_number), para que nenhum tempo de CPU conte duas vezes, uma linha por serviço. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
system.cpu.time.
Memory, disk and CPU pressure
Major page faults per second by service
Qualquer valor acima de zero é pressão de memória real: páginas voltando do disco.
- Como é calculado: A taxa por segundo de
process.paging.faultscomsystem.paging.fault.typemajor, só dos processos de servidor (os que não têmflutter.build.mode; o processo de um app Flutter nunca entra aqui), uma linha por serviço. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
process.paging.faults.
Root filesystem used
Disco cheio é serviço fora do ar. Mantenha abaixo de 80%.
- Como é calculado:
system.filesystem.usageno ponto de montagem/no estado used, somado, dividido por todo osystem.filesystem.usagedessa montagem, somado, mostrado em porcentagem. Um medidor de 0 a 100%, um único valor para todo o período escolhido. - Cores: O medidor fica âmbar acima de 80% e vermelho acima de 90%.
- Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
system.filesystem.usage.
Container CPU throttles per second by service
Qualquer valor acima de zero significa que o limite de CPU do cgroup é o gargalo: aumente-o.
- Como é calculado: A taxa por segundo de
dartastic.container.cpu.throttled.count, uma linha por serviço. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
dartastic.container.cpu.throttled.count.
Processes and per-CPU
Process CPU time per second by service and mode
O tempo de CPU que o processo de cada serviço usa, por modo.
- Como é calculado: A taxa por segundo de
process.cpu.timesó dos processos de servidor (os que não têmflutter.build.mode; o processo de um app Flutter nunca entra aqui), uma linha por serviço ecpu.mode. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
process.cpu.time.
Process uptime by service
O tempo desde que cada processo começou: um valor baixo é uma reinicialização recente.
- Como é calculado: Uptime: o relatório mais recente de
process.uptimepor serviço, só dos processos de servidor (os que não têmflutter.build.mode; o processo de um app Flutter nunca entra aqui), os vinte principais. Uma tabela, cada valor referente a todo o período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
process.uptime.
Busy share of each CPU by service
Cada linha é uma CPU de um host: a parcela do seu tempo fora do estado ocioso, de 0 a 1. Uma linha perto de 1 é uma CPU saturada.
- Como é calculado: A taxa por segundo de
system.cpu.timeem todos os modos exceto idle, só das séries por CPU (as que têm umcpu.logical_number), para que nenhum tempo de CPU conte duas vezes, uma linha por serviço ecpu.logical_number, as dezesseis principais. Linhas, um ponto por intervalo ao longo do período escolhido. - Filtros: O filtro Service restringe este painel.
- Abre: o título abre a tela Metric em
system.cpu.time.