Server Health仪表板
服务之下的服务器:负载与核心数对比、内存和文件描述符余量、套接字状态、I/O等待、缺页、磁盘、CPU限流,以及每个CPU的繁忙度。每个服务都标明其主机,因此用Service即可选定一台服务器。
适用对象: 负责保障服务器正常运行的人员:容量、余量和压力。
在Observatory的Dashboards中选择Server Health即可打开。这是内置仪表板,因此为只读;Save a copy可创建一个可修改的副本。每个面板如何读取时间范围、它的颜色和空状态,请参阅阅读仪表板。
工具栏:筛选器Service(在您选择值之前均为All)以及时间范围。每个菜单列出system.cpu.time在该时间范围内携带的值。下方每个面板都注明了可缩小其范围的筛选器。
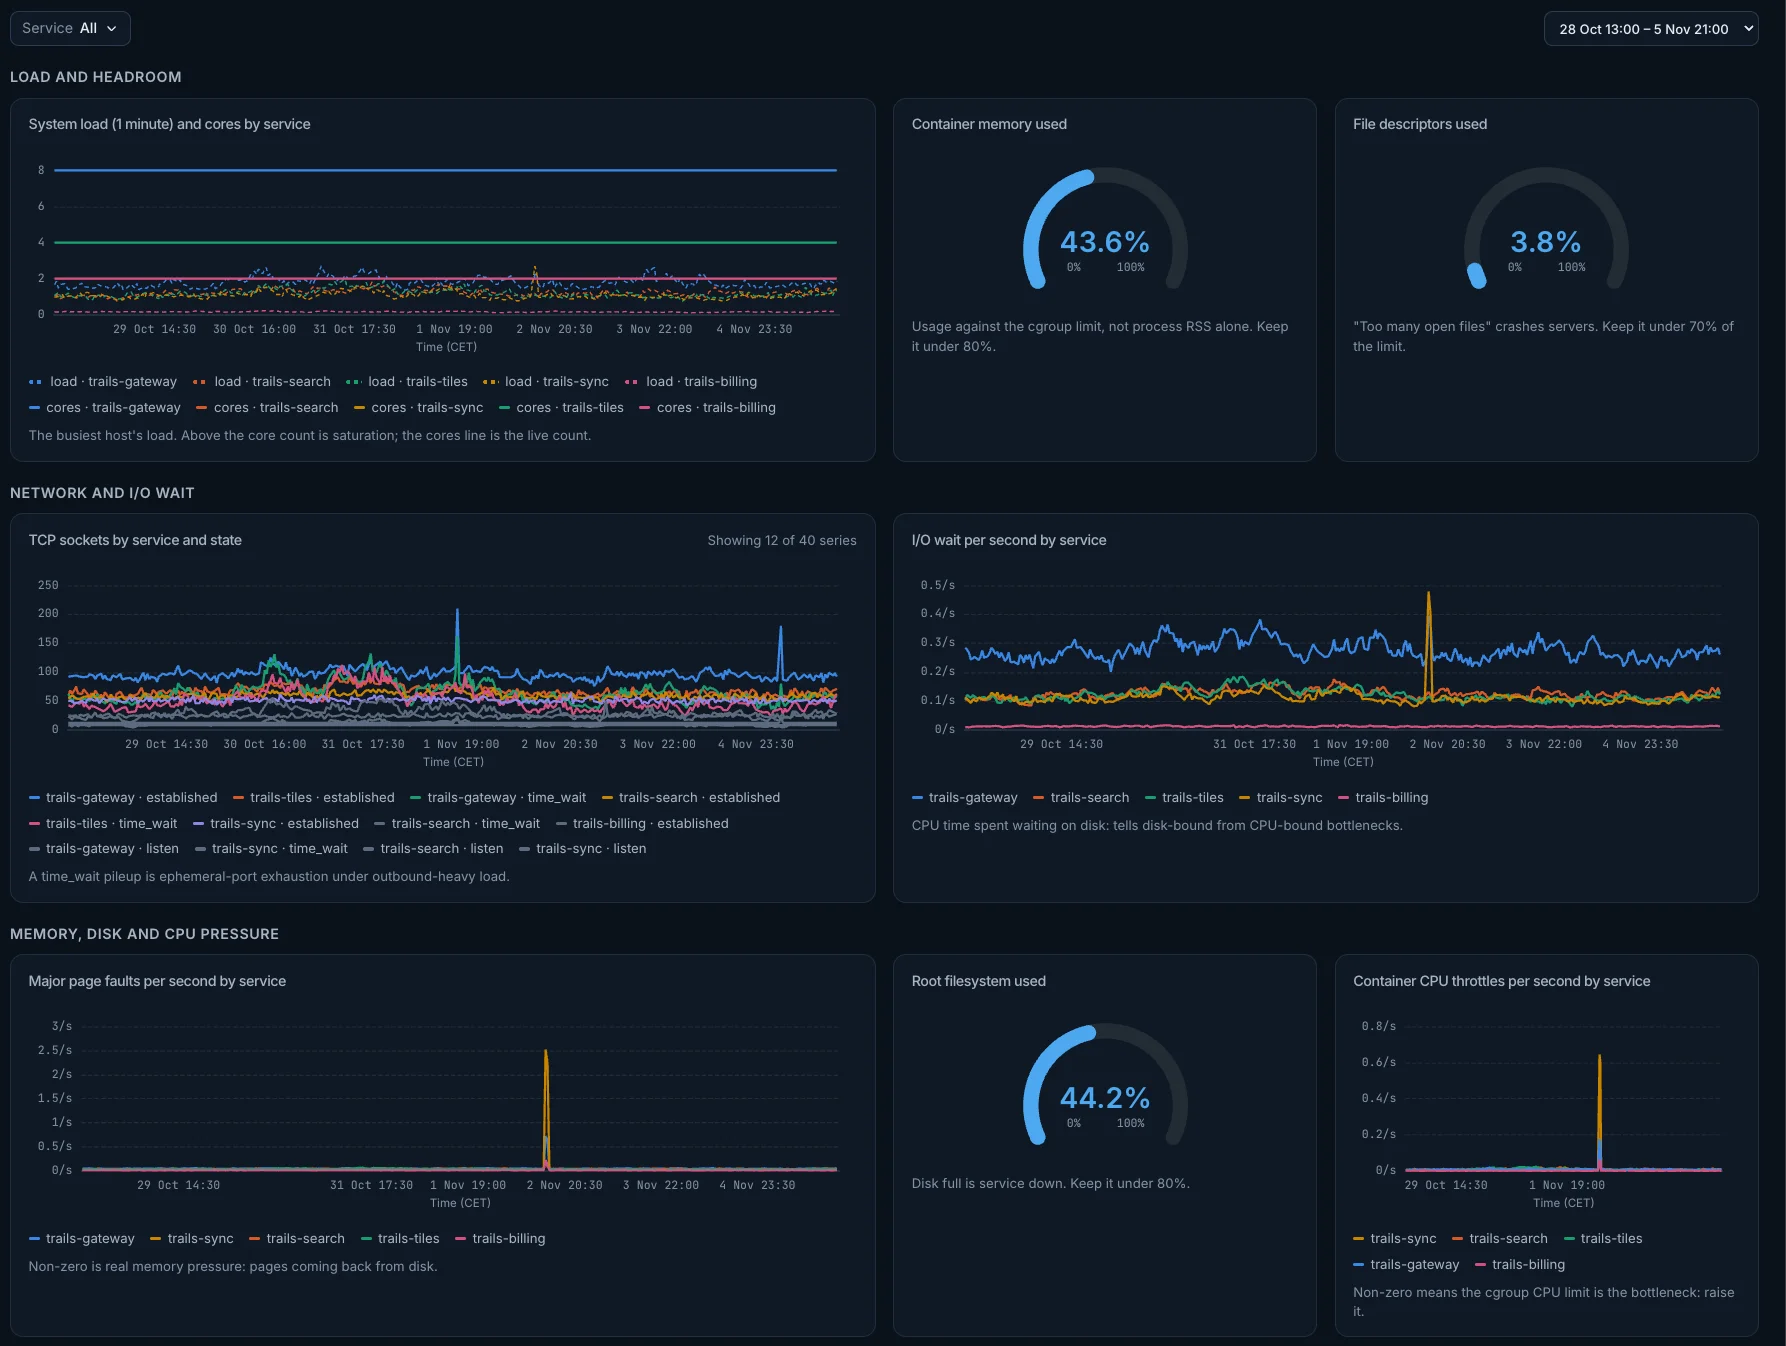
Load and headroom
System load (1 minute) and cores by service
最繁忙主机的负载。高于核心数即为饱和;核心数线是实时数量。
- 计算方式: 每个服务两条线:其主机中
dartastic.system.cpu.load_average.1m的最大值,以及system.cpu.time上不同cpu.logical_number值的数量(即核心数;汇总序列不带此属性)。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
dartastic.system.cpu.load_average.1m的Metric页面。
Container memory used
用量与cgroup限制的对比,而不仅是进程RSS。应保持在80%以下。
- 计算方式:
container.memory.usage的最大值除以dartastic.container.memory.limit的最大值,以百分比显示。 从0到100%的表盘,整个所选时间范围对应一个数值。 - 颜色: 表盘会变为琥珀色(高于80%)和红色(高于95%)。
- 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
container.memory.usage的Metric页面。
File descriptors used
“Too many open files”会让服务器崩溃。应保持在限制的70%以下。
- 计算方式:
process.unix.file_descriptor.count的最大值除以dartastic.process.open_file_descriptors.limit的最大值,仅来自服务器进程(不带flutter.build.mode的进程;Flutter应用的进程从不计入此处),以百分比显示。 从0到100%的表盘,整个所选时间范围对应一个数值。 - 颜色: 表盘会变为琥珀色(高于70%)和红色(高于90%)。
- 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
process.unix.file_descriptor.count的Metric页面。
Network and I/O wait
TCP sockets by service and state
time_wait堆积意味着在出站请求密集的负载下临时端口耗尽。
- 计算方式:
system.network.connection.count之和,每个服务和network.connection.state一条线,取前十二个。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
system.network.connection.count的Metric页面。
I/O wait per second by service
等待磁盘所花的CPU时间:用来区分磁盘瓶颈和CPU瓶颈。
- 计算方式:
cpu.mode为iowait的system.cpu.time每秒速率,只使用每个CPU的序列(带有cpu.logical_number的序列),因此CPU时间不会被重复计算,每个服务一条线。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
system.cpu.time的Metric页面。
Memory, disk and CPU pressure
Major page faults per second by service
非零即表示真实的内存压力:内存页正从磁盘换回。
- 计算方式:
system.paging.fault.type为major的process.paging.faults每秒速率,仅来自服务器进程(不带flutter.build.mode的进程;Flutter应用的进程从不计入此处),每个服务一条线。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
process.paging.faults的Metric页面。
Root filesystem used
磁盘写满即服务宕机。应保持在80%以下。
- 计算方式: 挂载点
/上处于used状态的system.filesystem.usage之和,除以该挂载点全部system.filesystem.usage之和,以百分比显示。 从0到100%的表盘,整个所选时间范围对应一个数值。 - 颜色: 表盘会变为琥珀色(高于80%)和红色(高于90%)。
- 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
system.filesystem.usage的Metric页面。
Container CPU throttles per second by service
非零表示cgroup的CPU限制就是瓶颈:请调高该限制。
- 计算方式:
dartastic.container.cpu.throttled.count的每秒速率,每个服务一条线。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
dartastic.container.cpu.throttled.count的Metric页面。
Processes and per-CPU
Process CPU time per second by service and mode
每个服务的进程按模式使用的CPU时间。
- 计算方式: 仅来自服务器进程(不带
flutter.build.mode的进程;Flutter应用的进程从不计入此处)的process.cpu.time每秒速率,每个服务和cpu.mode一条线。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
process.cpu.time的Metric页面。
Process uptime by service
每个进程启动以来的时间:数值低说明最近重启过。
- 计算方式: Uptime:每个服务
process.uptime的最新报告,仅来自服务器进程(不带flutter.build.mode的进程;Flutter应用的进程从不计入此处),取前二十个。 表格,所有数值都覆盖整个所选时间范围。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
process.uptime的Metric页面。
Busy share of each CPU by service
每条线代表一台主机的一个CPU:其非空闲时间所占比例,范围为0到1。接近1的线表示该CPU已饱和。
- 计算方式: 除idle以外所有模式下
system.cpu.time的每秒速率,只使用每个CPU的序列(带有cpu.logical_number的序列),因此CPU时间不会被重复计算,每个服务和cpu.logical_number一条线,取前十六个。 折线,在所选时间范围内每个时间步长一个数据点。 - 筛选器: Service筛选器会缩小此面板的范围。
- 打开: 点击标题会打开
system.cpu.time的Metric页面。